Chaves no ETL: por que Business Key, Primary Key, Hash e Surrogate Key não são a mesma coisa
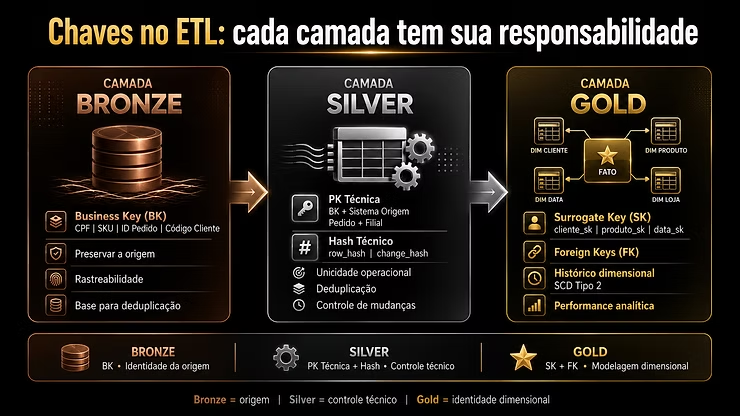
Em projetos de dados, existe um erro silencioso que compromete a qualidade da arquitetura desde a ingestão até a camada analítica: tratar todos os tipos de chave como se servissem ao mesmo propósito.
À primeira vista, parece um detalhe técnico. Afinal, se uma coluna identifica um registro, por que não usá-la em todas as camadas? Por que não usar o id_cliente da origem como chave da dimensão? Por que não usar um hash como identificador principal? Por que criar uma Surrogate Key na Gold se já existe uma Business Key aparentemente confiável?
A resposta é direta: porque cada camada da arquitetura de dados possui uma responsabilidade diferente.
E, consequentemente, cada tipo de chave também possui um papel diferente.
Esse é um dos pontos mais importantes da modelagem dimensional defendida por Ralph Kimball: o ambiente analítico não deve depender diretamente das chaves operacionais dos sistemas de origem. O Kimball Group afirma que o sistema DW/BI precisa assumir o controle das chaves primárias de todas as dimensões, criando chaves anônimas, inteiras e artificiais para cada dimensão, as SK's. (Kimball Group)
Em outras palavras: a chave que identifica um registro no sistema transacional não deve ser automaticamente promovida a chave principal do modelo dimensional.
Ignorar isso pode parecer inofensivo no início, mas costuma gerar problemas sérios de histórico, rastreabilidade, integração entre fontes, performance e manutenção.
O problema: usar a mesma chave para tudo
Em muitos pipelines modernos de dados, principalmente em arquiteturas Lakehouse, é comum encontrar a seguinte confusão:
A chave natural da origem é usada como identificador na Bronze.
Depois, essa mesma chave vira chave operacional na Silver.
Em seguida, ela é carregada para a Gold.
Na dimensão, ela continua sendo usada como chave principal.
Na fato, ela também é usada como referência para join.
O resultado é um pipeline que até funciona tecnicamente, mas que não respeita a separação entre ingestão, tratamento, integração e modelagem analítica.
Funcionar não significa estar bem modelado.
Uma arquitetura de dados sólida precisa separar claramente:
a identidade do dado na origem;
a unicidade técnica no pipeline;
o controle de mudança;
a identidade dimensional;
o relacionamento entre fatos e dimensões.
Esses conceitos estão relacionados, mas não são equivalentes.
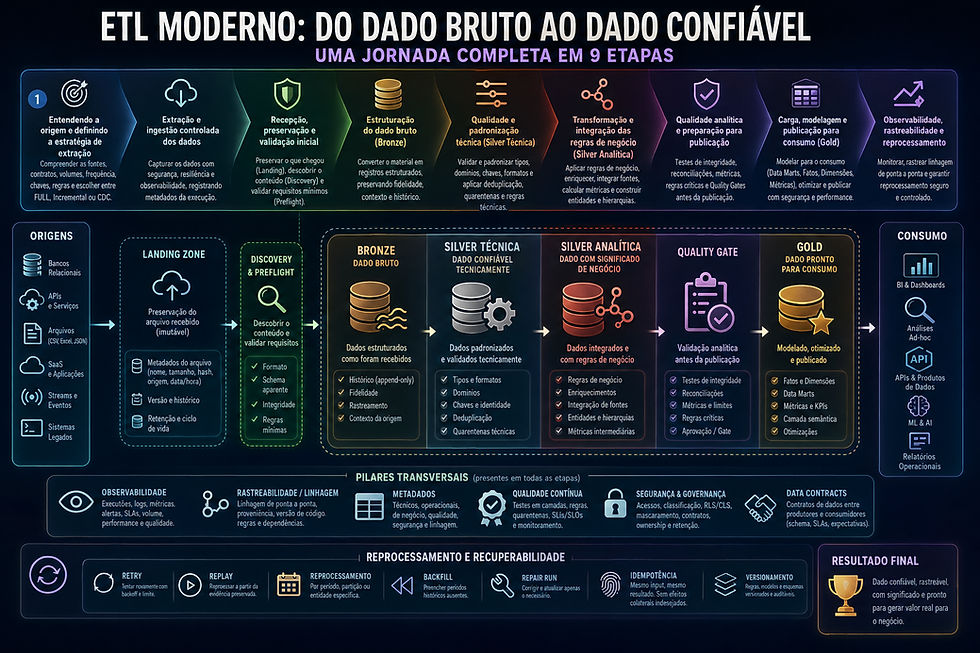
A engenharia de dados moderna reforça exatamente essa separação de responsabilidades. No livro Fundamentals of Data Engineering, Joe Reis e Matt Housley organizam a engenharia de dados em torno do ciclo de vida do dado: geração, ingestão, armazenamento, transformação e serving. A descrição da O’Reilly destaca também orquestração e governança como conceitos críticos em qualquer ambiente de dados. (O'Reilly Media)
Isso é importante porque Bronze, Silver e Gold não são apenas nomes bonitos. Elas representam momentos diferentes do ciclo de vida do dado. E cada momento exige decisões técnicas diferentes.
Business Key: a identidade do registro no mundo real
A Business Key, também chamada de chave natural ou chave de negócio, é o identificador que vem do domínio operacional.
Exemplos comuns:
cpf
cnpj
codigo_cliente
codigo_produto
sku
numero_pedido
id_conta
id_contrato
Ela representa como o negócio ou o sistema de origem identifica uma entidade.
Na prática, a Business Key é essencial porque conecta o dado analítico à realidade operacional. Sem ela, você perde a capacidade de rastrear um registro de volta para sua origem.
Porém, a Business Key não deve ser confundida com a chave dimensional final.
Ela pode mudar, ser reutilizada, vir nula, ter formatos diferentes entre sistemas, variar entre filiais, sofrer correções manuais ou não ser globalmente única.
Um codigo_cliente = 123, por exemplo, pode significar uma pessoa em um sistema e outra pessoa em outro sistema. Um CPF pode sofrer correção cadastral. Um SKU pode ser reaproveitado. Um ID de pedido pode ser único apenas dentro de uma filial, agência, empresa ou sistema específico.
Por isso, a Business Key é indispensável para rastreabilidade e integração, mas não deve ser tratada como a identidade definitiva da dimensão analítica.
A própria literatura de Kimball diferencia as chaves naturais criadas pelos sistemas operacionais das chaves controladas pelo ambiente DW/BI. Essa diferença existe porque o sistema analítico precisa ser protegido das instabilidades e regras específicas das aplicações de origem. (Kimball Group)
Bronze: preservar a realidade da origem
A camada Bronze deve preservar o dado bruto ou o mais próximo possível da origem.
O papel da Bronze não é modelar dimensionalmente. Também não é enriquecer o dado com regras de negócio complexas. Sua responsabilidade principal é capturar, armazenar e manter a rastreabilidade do que foi recebido.
Nesse contexto, a Business Key deve ser preservada exatamente como veio da origem.
Exemplo:
id_cliente
cpf codigo_produto numero_pedido sistema_origem data_ingestao arquivo_origem
A Bronze precisa permitir auditoria, reprocessamento e comparação com o sistema fonte.
Por isso, criar Surrogate Keys dimensionais nessa camada costuma ser um erro arquitetural. A Bronze ainda não sabe o contexto analítico completo. Ela não deve assumir decisões que pertencem à modelagem dimensional da Gold.
A Bronze responde perguntas como:
O que chegou?
Quando chegou?
De qual origem veio?
Qual era o valor original?
Consigo reprocessar esse dado?
Consigo auditar esse registro?
Ela não deve responder ainda:
Qual é a chave da dimensão cliente?
Qual versão histórica desse cliente vale para essa venda?
Qual linha da dimensão será referenciada pela fato?
Essas perguntas pertencem a camadas posteriores.
Silver: unicidade, padronização e controle técnico
A camada Silver é onde o dado começa a ser tratado tecnicamente.
Aqui entram processos como:
padronização de nomes de colunas;
conversão de tipos;
deduplicação;
tratamento de nulos;
normalização de domínios;
validação de regras técnicas;
controle de incrementalidade;
detecção de mudanças;
aplicação de SCD quando fizer sentido;
consolidação entre fontes.
Nessa camada, a Business Key continua sendo importante, mas geralmente ela precisa ser combinada com outros campos para garantir unicidade.
Por exemplo:
id_cliente + sistema_origem
numero_conta + agencia
codigo_produto + empresa
numero_pedido + filial
Essa composição pode funcionar como uma Primary Key técnica da tabela Silver.
Mas aqui existe um ponto importante: essa PK técnica não é necessariamente a chave da dimensão na Gold.
Ela serve para garantir a unicidade operacional do pipeline, não para representar a identidade dimensional definitiva.
Primary Key técnica na Silver
A Primary Key técnica da Silver tem uma função prática: garantir que cada registro tratado tenha uma identidade única dentro daquele conjunto de dados.
Exemplo:
cliente_id,
sistema_origem
Ou:
agencia,
numero_conta,
codigo_bloqueio
Em muitos casos, essa chave composta representa melhor a realidade do pipeline do que uma única coluna da origem.
Ela é usada para:
deduplicar registros;
controlar merges;
evitar duplicidades técnicas;
validar unicidade;
organizar cargas incrementais;
identificar o registro corrente dentro da camada tratada.
Mas ela ainda não resolve sozinha o problema dimensional.
Principalmente quando existe histórico.
Aqui também entra qualidade de dados. Uma chave mal definida compromete unicidade, consistência, validade e integridade dos dados. Embora a discussão pareça apenas modelagem, ela também é uma discussão de qualidade, porque a escolha incorreta da chave pode gerar duplicidade silenciosa, perda de histórico e inconsistência entre tabelas analíticas.
Hash técnico: ferramenta de engenharia, não chave dimensional
Outro erro comum é usar hash como se fosse chave de negócio ou Surrogate Key.
O hash é extremamente útil em pipelines de dados, especialmente para detectar mudanças entre versões de um registro.
Exemplo:
sha2(concat_ws('|',
    nome_cliente,
    data_nascimento,
    status_cliente,
    cidade,
    uf
), 256) as row_hash
Esse hash permite comparar rapidamente se os atributos relevantes de um registro mudaram.
Ele é muito usado em cargas incrementais, SCD Tipo 1, SCD Tipo 2 e processos idempotentes.
Mas hash não é a mesma coisa que Surrogate Key.
O hash responde:
O conteúdo deste registro mudou?
Esta versão é diferente da anterior?
Preciso atualizar ou inserir uma nova linha?
A Surrogate Key responde:
Qual é a identidade artificial e única desta linha dimensional?
Qual versão da dimensão deve ser referenciada pela fato?
São perguntas diferentes.
O hash é uma ferramenta de controle de mudança. A Surrogate Key é uma chave de relacionamento dimensional.
Misturar os dois conceitos costuma gerar modelos difíceis de manter.
Gold: onde a modelagem dimensional entra de verdade
A camada Gold é onde o dado deve estar preparado para consumo analítico.
É aqui que entram modelos como:
Star Schema;
dimensões;
fatos;
métricas;
indicadores;
hierarquias;
atributos descritivos;
chaves substitutas;
relacionamentos analíticos.
Segundo a abordagem de Kimball, o modelo dimensional deve ser simples para consumo, performático para consulta e estável para análise histórica.
E é aqui que a Surrogate Key se torna indispensável.
Surrogate Key: a chave real da dimensão
A Surrogate Key é uma chave artificial, sem significado de negócio, criada exclusivamente para identificar uma linha da dimensão.
Exemplo:
cliente_sk
produto_sk
data_sk
agencia_sk
conta_sk
Normalmente, ela é numérica, como um bigint, e não carrega semântica de negócio.
Exemplo de dimensão:
cliente_sk | cliente_bk | nome_cliente | cidade   | status | data_inicio | data_fim   | flag_atual
-----------|------------|--------------|----------|--------|-------------|------------|------------
1          | 123        | João Silva   | Salvador | Ativo  | 2024-01-01  | 2024-08-10 | false
2          | 123        | João Silva   | Recife   | Ativo  | 2024-08-11  | 9999-12-31 | true
Observe que a Business Key é a mesma:
cliente_bk = 123
Mas existem duas versões históricas do cliente.
Cada versão precisa ter uma Surrogate Key própria:
cliente_sk = 1
cliente_sk = 2
É isso que permite ao modelo preservar histórico corretamente.
Kimball trata esse ponto como central: as Surrogate Keys dimensionais devem ser inteiros simples, atribuídos quando uma nova chave é necessária, justamente para que o ambiente DW/BI controle a identidade das dimensões. (Kimball Group)
Por que Kimball defende Surrogate Keys?
A Surrogate Key resolve problemas que a Business Key não consegue resolver bem em modelos dimensionais.
1. Preservação de histórico
No SCD Tipo 2, uma mesma entidade de negócio pode ter várias versões ao longo do tempo.
Se um cliente muda de cidade, estado civil, segmento, gerente, agência ou status, talvez você precise preservar o histórico dessa mudança.
Com Surrogate Key, cada versão da dimensão recebe uma identidade própria.
Sem Surrogate Key, a fato não consegue apontar com precisão para a versão correta da dimensão no momento do evento.
O Kimball Group descreve o SCD Tipo 2 como uma técnica que adiciona uma nova linha na dimensão com os valores atualizados, exigindo a generalização da chave primária, já que podem existir múltiplas linhas descrevendo o mesmo membro de negócio. (Kimball Group)
Esse é o ponto técnico central: quando há múltiplas versões para a mesma Business Key, a Business Key sozinha não identifica mais uma linha única da dimensão.
Ela identifica a entidade de negócio.
Mas não identifica a versão histórica daquela entidade.
2. Independência dos sistemas de origem
Sistemas transacionais mudam.
Chaves naturais podem ser alteradas, corrigidas, reaproveitadas ou migradas.
Se o modelo analítico depende diretamente da chave operacional, qualquer alteração na origem pode impactar a Gold.
A Surrogate Key protege o modelo dimensional contra instabilidades dos sistemas fonte.
Essa ideia também aparece em documentações modernas de modelagem dimensional. A Microsoft, por exemplo, descreve a Surrogate Key como uma chave gerada e armazenada na dimensão, usada como primary key para relacionamento com outras tabelas do modelo dimensional, além de ajudar a isolar o Data Warehouse de mudanças nos dados de origem. (Microsoft Learn)
3. Integração de múltiplas fontes
Imagine que o cliente venha de mais de um sistema:
CRM
ERP
Core bancário
Sistema legado
Plataforma digital
Cada sistema pode ter seu próprio identificador.
A dimensão precisa consolidar essas identidades em uma visão analítica única.
A Surrogate Key permite criar uma identidade dimensional independente das várias chaves naturais das origens.
Nesse cenário, a Business Key continua sendo necessária, mas precisa ser contextualizada:
cliente_bk + sistema_origem
cpf + tipo_documento + pais
codigo_cliente + empresa
A SK, por outro lado, representa a identidade da linha dimensional já resolvida dentro da Gold.
4. Performance em consultas analíticas
Chaves numéricas são mais eficientes para joins do que chaves textuais longas, compostas ou semânticas.
Em um Star Schema, a tabela fato pode conter milhões ou bilhões de linhas.
Se a fato armazena várias Business Keys compostas, o modelo tende a ficar maior, mais pesado e menos eficiente.
Com Surrogate Keys numéricas, os relacionamentos ficam mais simples e performáticos.
5. Separação entre semântica de negócio e estrutura analítica
A Business Key pertence ao domínio do negócio.
A Surrogate Key pertence ao modelo analítico.
Essa separação é saudável.
O usuário de negócio pode continuar vendo CPF, código do cliente, SKU ou número do pedido.
Mas o mecanismo de relacionamento entre fato e dimensão deve ser controlado pelo modelo dimensional.
A fato deve armazenar Business Key?
Em um Star Schema bem modelado, a tabela fato deve referenciar as dimensões por meio das Surrogate Keys.
Exemplo:
fato_vendas

data_sk
cliente_sk
produto_sk
loja_sk
quantidade
valor_bruto
valor_liquido
A fato não deveria depender diretamente de campos como estes para relacionamento dimensional principal:
cpf
codigo_cliente
codigo_produto
numero_loja
Esses campos podem até existir em cenários específicos para auditoria, reconciliação, troubleshooting ou rastreabilidade técnica.
O erro não é a BK existir na fato.
O erro é a BK ser usada como FK principal do Star Schema.
O relacionamento principal deve ser:
fato.cliente_sk -> dim_cliente.cliente_sk
fato.produto_sk -> dim_produto.produto_sk
fato.data_sk -> dim_data.data_sk
Esse é o desenho clássico do Star Schema.
A própria documentação de Kimball sobre Surrogate Keys reforça que o DW/BI deve controlar as chaves primárias das dimensões, em vez de depender de chaves naturais explícitas ou chaves naturais acompanhadas de datas. (Kimball Group)
Exemplo prático: cliente com mudança de endereço
Imagine uma venda realizada em janeiro de 2024.
Naquele momento, o cliente morava em Salvador.
Em agosto de 2024, o cliente mudou para Recife.
Se a dimensão cliente usa SCD Tipo 2, teremos duas versões:
cliente_sk | cliente_bk | cidade   | data_inicio | data_fim
-----------|------------|----------|-------------|------------
10         | 123        | Salvador | 2024-01-01  | 2024-08-10
25         | 123        | Recife   | 2024-08-11  | 9999-12-31
A venda de janeiro deve apontar para:
cliente_sk = 10
A venda de setembro deve apontar para:
cliente_sk = 25
Se a fato usasse apenas:
cliente_bk = 123
ela não saberia qual versão histórica do cliente considerar.
O histórico ficaria ambíguo.
Esse é exatamente o tipo de problema que a Surrogate Key resolve.
Kimball reforça esse raciocínio ao afirmar que, em uma mudança Tipo 2, deve-se criar uma nova surrogate primary key sempre que uma nova versão da dimensão for processada. (Kimball Group)
Onde cada chave deve ser usada
De forma prática, podemos organizar assim:
Camada | Tipo de chave | Papel principal |
Bronze | Business Key | Preservar a identificação original da fonte |
Silver | Business Key + PK técnica | Deduplicar, padronizar, controlar unicidade e preparar integração |
Silver | Hash técnico | Detectar mudanças e apoiar idempotência |
Gold Dimensão | Surrogate Key | Identificar unicamente cada linha dimensional |
Gold Fato | Foreign Key baseada em SK | Relacionar eventos às dimensões corretas |
Essa separação evita que a arquitetura fique acoplada demais à origem.
Um cuidado importante: a Business Key não desaparece na Gold
Defender o uso de Surrogate Key não significa apagar a Business Key da dimensão.
Pelo contrário.
A dimensão deve manter a Business Key como atributo de rastreabilidade.
Exemplo:
dim_cliente

cliente_sk
cliente_bk
sistema_origem
nome_cliente
cpf
cidade
status
data_inicio
data_fim
flag_atual
A diferença é que a Business Key não deve ser a Primary Key da dimensão.
Ela continua existindo, mas como atributo de negócio e rastreabilidade.
A Primary Key dimensional deve ser a Surrogate Key.
O erro de criar Surrogate Key cedo demais
Outro problema comum é criar Surrogate Key na Bronze ou no início da Silver.
Isso pode gerar uma falsa sensação de organização.
Mas a Surrogate Key dimensional só faz sentido quando você já tem clareza sobre:
qual é a entidade dimensional;
qual é o grão da dimensão;
quais atributos serão historificados;
qual regra de SCD será usada;
qual é a Business Key consolidada;
como múltiplas fontes serão integradas;
como as fatos farão lookup para a dimensão.
Antes disso, a SK pode virar apenas um identificador técnico sem valor dimensional real.
A Surrogate Key deve nascer no contexto da dimensão, não no contexto bruto da ingestão.
Esse ponto conversa diretamente com a visão de ciclo de vida da engenharia de dados: ingestão, armazenamento, transformação e serving são etapas diferentes, com responsabilidades diferentes. (O'Reilly Media)
Diferença entre chave técnica e chave dimensional
Esse ponto é sutil, mas importante.
Uma tabela Silver pode ter uma chave técnica para controle de carga.
Exemplo:
id_cliente + sistema_origem
Ou até um hash de chave:
sha2(id_cliente || sistema_origem)
Isso pode ser perfeitamente válido para engenharia de dados.
Mas essa chave técnica não é automaticamente uma Surrogate Key dimensional.
A chave técnica da Silver existe para o pipeline funcionar corretamente.
A Surrogate Key da Gold existe para o modelo analítico representar corretamente fatos, dimensões e histórico.
Chaves também são qualidade de dados
Muitas vezes, o debate sobre chaves é tratado apenas como uma decisão de modelagem.
Mas ele também é uma decisão de qualidade de dados.
Uma chave mal definida pode gerar:
duplicidade;
perda de unicidade;
erro de integração;
join incorreto;
histórico quebrado;
fato apontando para dimensão errada;
métrica inconsistente;
dificuldade de auditoria.
Em fundamentos de qualidade de dados, dimensões como unicidade, consistência, validade, completude e acurácia são frequentemente usadas para avaliar se um dado é confiável para consumo. Quando uma chave é mal escolhida, várias dessas dimensões são afetadas ao mesmo tempo.
Por exemplo:
Se a Business Key não é globalmente única, a unicidade é comprometida.

Se uma fato aponta para a versão errada da dimensão, a consistência histórica é comprometida.

Se uma chave vem nula ou fora do padrão esperado, a validade é comprometida.

Se múltiplas fontes identificam a mesma entidade de formas diferentes, a integridade analítica é comprometida.
Portanto, discutir chaves não é preciosismo técnico.
É discutir a confiabilidade do dado como produto final.
O impacto de ignorar esse assunto
Quando o projeto ignora a diferença entre Business Key, PK técnica, Hash e Surrogate Key, alguns problemas aparecem:
fatos apontando para versões erradas de dimensões;
perda de histórico em SCD Tipo 2;
joins complexos e pouco performáticos;
dependência excessiva dos sistemas de origem;
dificuldade de integrar múltiplas fontes;
duplicidades silenciosas;
modelos analíticos frágeis;
retrabalho em BI;
métricas inconsistentes;
baixa confiança no Data Warehouse.
Muitas vezes, o problema só aparece meses depois, quando o volume aumenta, novas fontes entram no pipeline ou o negócio começa a exigir análise histórica mais precisa.
É nesse momento que uma decisão aparentemente pequena sobre chaves se transforma em dívida técnica arquitetural.
Conclusão
Chaves não são apenas detalhes de implementação.
Elas definem como o dado será identificado, rastreado, integrado, historificado e consumido.
A Business Key conecta o dado ao mundo real.
A Primary Key técnica garante unicidade operacional no pipeline.
O hash ajuda a detectar mudanças e controlar cargas.
A Surrogate Key dá identidade dimensional às versões históricas.
A Foreign Key conecta os eventos da fato às dimensões corretas.
Cada uma tem seu papel.
Cada uma tem seu momento.
Cada uma existe para resolver um problema diferente.
A grande lição da modelagem dimensional de Kimball é que o Data Warehouse não deve ser uma cópia ingênua dos sistemas de origem. Ele precisa ser uma estrutura analítica desenhada para responder perguntas de negócio com consistência, performance e preservação histórica.
E isso começa por algo que muita gente ignora: escolher corretamente as chaves.
No fim, separar bem esses conceitos é o que diferencia um pipeline que apenas movimenta dados de uma arquitetura analítica realmente confiável.
Referências
Ralph Kimball / Kimball Group — Dimension Surrogate Keys.
Ralph Kimball / Kimball Group — Slowly Changing Dimensions Type 2.
Ralph Kimball — Slowly Changing Dimensions, Part 2.
Ralph Kimball, Margy Ross — The Data Warehouse Toolkit.
Joe Reis, Matt Housley — Fundamentals of Data Engineering.
Microsoft Learn — Modeling Dimension Tables in Warehouse.
DAMA International — conceitos de qualidade de dados, governança e gestão de dados.


Comentários