ETL Moderno: do dado bruto ao dado confiável — uma jornada completa em 9 etapas
Introdução
Durante muito tempo, explicar ETL parecia relativamente simples:
Extract → Transform → Load
Extraímos dados de uma fonte, realizamos transformações e carregamos o resultado em um destino.
Essa definição continua correta conceitualmente, mas já não representa, sozinha, a complexidade dos ecossistemas modernos de dados.
Hoje lidamos simultaneamente com bancos relacionais, APIs, arquivos CSV, Excel, JSON, XML, Parquet, eventos, streaming, sistemas legados, aplicações SaaS e inúmeras outras fontes. Os dados chegam em volumes diferentes, frequências diferentes, níveis de qualidade diferentes e, principalmente, com diferentes expectativas de disponibilidade e confiabilidade.
Ao mesmo tempo, o consumidor espera muito mais do que uma tabela carregada.
Ele espera dados:
corretos;
atualizados;
rastreáveis;
documentados;
seguros;
consistentes;
historizados quando necessário;
recuperáveis diante de falhas;
performáticos;
compreensíveis para o negócio.
Isso muda completamente a forma de pensar um pipeline.
Joe Reis e Matt Housley tratam a Engenharia de Dados a partir de um ciclo de vida, indo muito além da simples movimentação entre origem e destino. Nesse ciclo entram geração, ingestão, armazenamento, transformação e consumo, acompanhados por preocupações transversais como segurança, governança, gerenciamento de dados e DataOps.
James Serra, ao discutir diferentes arquiteturas de dados — Data Warehouse, Data Lake, Modern Data Warehouse, Data Lakehouse, Data Fabric e Data Mesh — também evidencia que não existe uma única arquitetura universal: as escolhas precisam estar relacionadas ao problema, ao contexto e aos requisitos de consumo.
Já Bartosz Konieczny aborda a Engenharia de Dados sob a ótica de padrões recorrentes, incluindo Full Load, Incremental Load, CDC, tratamento de erros, deduplicação e idempotência, reforçando que muitos problemas encontrados nos pipelines não são novos e podem ser tratados por meio de padrões arquiteturais bem definidos.
E quando entramos no tema confiabilidade, Barr Moses, Lior Gavish e Molly Vorwerck colocam em primeiro plano uma realidade importante: um pipeline pode executar perfeitamente e ainda assim entregar dados ruins. Qualidade e observabilidade precisam fazer parte do sistema, e não aparecer somente quando um dashboard quebra.
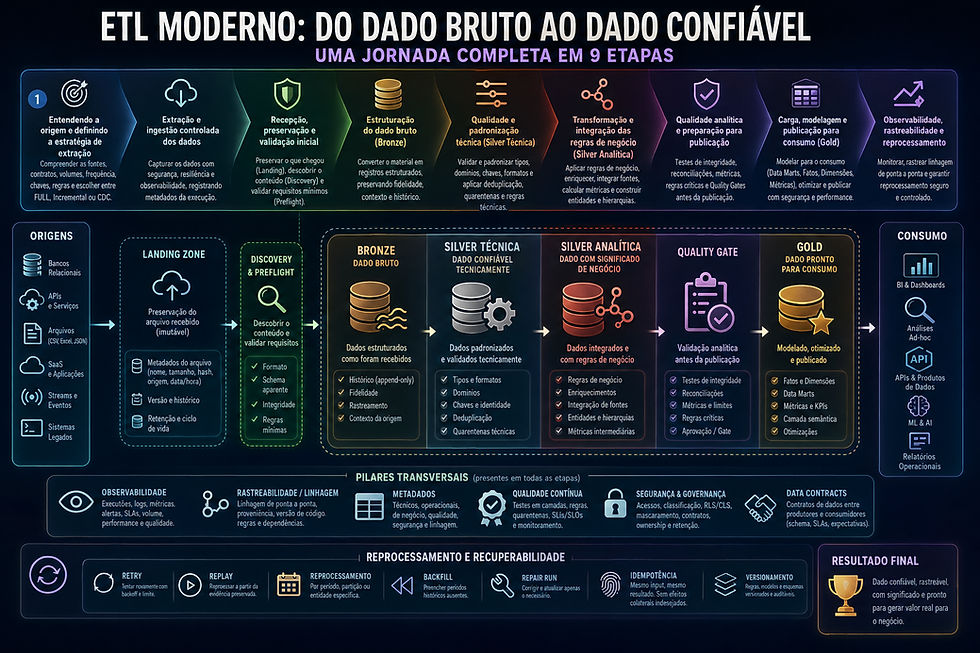
É a partir dessa visão que proponho neste artigo uma jornada em nove macroetapas:
1. Entender a origem e definir a estratégia de extração
2. Extrair e ingerir os dados de forma controlada
3. Receber, preservar e validar o material recebido
4. Estruturar o dado bruto
5. Garantir qualidade e padronização técnica
6. Aplicar e integrar regras de negócio
7. Validar analiticamente antes da publicação
8. Modelar e publicar para consumo
9. Observar, rastrear e permitir reprocessamento
Embora sejam apresentadas sequencialmente, essas etapas não formam apenas uma corrente linear.
Qualidade, segurança, governança, contratos, metadados, observabilidade e rastreabilidade atravessam todo o processo.
ETL ou ELT?
Antes de avançarmos, existe uma distinção técnica importante.
Na arquitetura clássica:
Extract → Transform → Load
Grande parte da transformação ocorria antes que o dado fosse carregado no ambiente analítico.
Em plataformas modernas, especialmente Data Lakes e Lakehouses, é bastante comum seguir algo mais próximo de:
Extract → Load Raw → Transform → Validate → Transform → Publish
Ou seja, na prática:
E → L → T → T → L
O dado é capturado e persistido inicialmente com elevada fidelidade, e só depois é submetido às transformações progressivas.
Por isso, tecnicamente, muitas arquiteturas que continuamos chamando genericamente de ETL estão muito mais próximas de ELT.
Neste artigo utilizarei o termo ETL moderno em sentido amplo, representando a jornada completa do dado, sem limitar a discussão ao posicionamento físico da transformação.
O ponto central não é o acrônimo.
O ponto central é compreender as responsabilidades que precisam existir entre a origem e o consumo.
O princípio fundamental: cada etapa deve responder uma pergunta
Uma arquitetura sustentável possui fronteiras claras.
Cada etapa deve existir para responder a uma pergunta específica:
Origem e estratégia
O que precisamos capturar e como devemos fazê-lo?
Ingestão
Conseguimos capturar o material?
Landing
Conseguimos preservar exatamente o que recebemos?
Discovery e Preflight
O material possui condições técnicas mínimas para ser processado?
Bronze
O que efetivamente foi ingerido e como podemos representá-lo de maneira estruturada?
Silver Técnica
O dado está tecnicamente consistente?
Silver Analítica
O que esse dado significa para o negócio?
Quality Gate analítico
Podemos confiar no resultado para consumo?
Gold
Como disponibilizamos essa informação de forma simples, eficiente e governada?
Observabilidade e reprocessamento
O que aconteceu, por que aconteceu e como recuperamos o sistema quando necessário?
Quando essas fronteiras não estão claras, as responsabilidades começam a se misturar.
E é aí que surgem pipelines difíceis de manter.
1. Entendendo a origem e definindo a estratégia de extração
Um pipeline não deveria começar com código.
Deveria começar com entendimento.
Antes de escrever uma consulta SQL, implementar uma chamada HTTP ou configurar um conector, precisamos compreender a fonte.
Essa etapa inicial pode parecer excessivamente conceitual, mas muitas das falhas encontradas posteriormente são apenas consequências de decisões mal tomadas aqui.
Caracterizando a fonte
Precisamos responder, entre outras, às seguintes perguntas:
Qual é o sistema produtor?
Pode ser:
banco relacional;
API REST;
arquivo;
planilha;
sistema legado;
evento;
fila;
stream;
aplicação SaaS;
banco NoSQL.
Qual é o contrato esperado?
Precisamos conhecer:
campos;
tipos;
nulabilidade;
granularidade;
identificadores;
domínios;
unidades;
timezone;
semântica dos deletes;
frequência de atualização.
Um contrato de dados não deve ser entendido simplesmente como um JSON Schema ou uma lista de colunas.
Um contrato realmente útil pode incluir:
schema + granularidade + identidade + semântica + qualidade + temporalidade + disponibilidade + segurança
FULL, incremental ou CDC?
Uma das primeiras decisões é determinar como as mudanças serão capturadas.
Full Load
Todos os registros são extraídos novamente.
É conceitualmente simples e pode ser excelente para conjuntos pequenos.
Mas aumenta:
custo computacional;
tráfego;
tempo;
impacto sobre a origem.
Incremental
Somente dados novos ou alterados são extraídos.
Normalmente depende de algum mecanismo como:
updated_at;
ID crescente;
partição;
sequência;
watermark.
O problema é que incrementais parecem simples até que a primeira carga falhe.
Imagine:
watermark atual = 10:00;
começamos uma carga até 11:00;
o processo atualiza o watermark para 11:00;
a carga falha antes de persistir todos os registros.
Na próxima execução, começamos depois das 11:00.
Criamos uma lacuna.
Por isso, uma arquitetura robusta normalmente diferencia:
watermark candidata de watermark confirmada
A marca deve avançar apenas quando a execução relevante atingir o estado considerado seguro.
CDC
Change Data Capture permite capturar mudanças da origem de maneira mais granular.
Mas CDC não elimina outros problemas.
Ainda precisamos tratar:
identidade;
ordenação;
duplicidade;
deletes;
eventos fora de ordem;
replay.
Em processamento distribuído, entregar o mesmo evento mais de uma vez frequentemente é uma possibilidade real.
Portanto:
CDC não elimina a necessidade de idempotência.
Antes de extrair, precisamos entender o dado
Outro erro recorrente é confiar excessivamente no tipo físico da origem.
Um campo numérico pode representar:
CPF;
número de conta;
código de agência;
matrícula;
CEP.
Nesse caso, semanticamente ele pode ser uma string.
Tipos devem refletir o significado do atributo, e não somente sua aparência.
Essa diferença será fundamental nas próximas etapas.
2. Extração e ingestão controlada dos dados
Depois que entendemos a origem, começamos efetivamente a movimentar o dado.
Mas ingestão não significa apenas:
copiar do ponto A para o ponto B.
Precisamos garantir:
segurança + controle + rastreabilidade + resiliência
Extração confiável
A implementação deve respeitar a estratégia definida anteriormente.
Em bancos relacionais, isso pode significar:
filtros;
predicados incrementais;
particionamento;
consistência da leitura;
controle da pressão sobre a origem.
Em APIs:
paginação;
rate limits;
tokens;
retry;
timeout;
backoff;
tratamento de respostas incompletas.
Um detalhe particularmente perigoso:
HTTP 200 não significa necessariamente carga válida.
Uma API pode retornar status de sucesso e ainda entregar:
página vazia;
payload parcial;
conteúdo inconsistente;
mensagem de erro encapsulada no JSON.
Em arquivos, outros problemas aparecem:
encoding;
delimitadores;
BOM;
cabeçalho;
arquivo vazio;
transferência incompleta.
Transporte
O dado precisa chegar ao ambiente controlado de maneira segura.
Dependendo do cenário, podemos utilizar:
HTTPS;
SFTP;
VPN;
Private Link;
mecanismos nativos de cloud;
filas;
brokers.
Aqui também entram criptografia, identidade de serviço e princípio do menor privilégio.
Metadados da execução
Desde a ingestão já deveríamos capturar informações capazes de responder:
qual origem?
qual entidade?
qual período?
quando começou?
quando terminou?
quantos registros?
qual estratégia?
qual status?
houve retry?
qual código executou?
Um identificador como:
run_id
é extremamente valioso.
Mas ele não deve ser confundido com outros conceitos, como batch_id.
Uma execução pode processar um lote.
Um lote pode ser reprocessado em várias execuções.
Essa distinção parece pequena até o momento em que precisamos investigar um incidente.
3. Recepção, preservação e validação inicial
O dado chegou.
A primeira reação de uma arquitetura madura não deveria ser transformá-lo.
Deveria ser:
preservá-lo.
É aqui que entra a Landing Zone.
Landing Zone: preservar antes de interpretar
A Landing deve responder:
O que exatamente recebemos da origem?
Sua principal responsabilidade é manter evidência do material recebido.
Isso viabiliza:
auditoria;
investigação;
replay;
reprocessamento;
comparação com a origem;
recuperação após bugs;
análise de mudança de schema.
Considere:
transacoes_20260812.csv
Se imediatamente transformamos o arquivo e descartamos o original, perdemos uma referência importante.
Se futuramente descobrirmos que o parser interpretou decimal, encoding ou delimitador incorretamente, talvez não consigamos reproduzir aquilo que realmente chegou.
Por isso:
Landing não é Bronze.
A Landing preserva o objeto.
A Bronze representará seus registros.
Imutabilidade
Preferencialmente, um objeto recebido não deveria ser silenciosamente sobrescrito.
Se um fornecedor envia uma versão corrigida, deveríamos preservar:
versão original
e
versão corrigida
com seus respectivos contextos.
Imutabilidade não significa que fisicamente nada pode ser removido para sempre.
Retenção e lifecycle continuam existindo.
Significa que não devemos apagar a história operacional enquanto ela ainda possui valor de auditoria e recuperação.
Discovery: o que aparentemente recebemos?
Depois de preservar, precisamos entender o objeto.
Discovery procura identificar características como:
formato;
encoding;
delimitador;
compressão;
estrutura;
schema aparente;
sheets de um Excel;
campos de um JSON;
namespace XML.
Observe a palavra:
aparente.
Um arquivo chamado:
clientes.csv
não necessariamente contém CSV.
Pode conter:
<html>
  Error 500
</html>
Isso acontece, por exemplo, quando um processo de download salva uma página de erro com o nome esperado do arquivo.
Confiar apenas na extensão seria perigoso.
Preflight: podemos processar?
Depois do Discovery, o Preflight compara aquilo que encontramos com as condições mínimas necessárias.
Discovery responde:
O que parece ter chegado?
Preflight responde:
Aquilo que chegou está tecnicamente apto?
Podemos verificar:
integridade;
arquivo completo;
quantidade mínima de colunas;
schema;
encoding;
formato;
existência de sheets;
consistência estrutural;
manifestos;
checksums.
Essa ainda não é uma validação de negócio.
Se encontrarmos:
saldo = -1000
o Preflight não deveria necessariamente afirmar que o saldo está errado.
Sua responsabilidade é verificar se conseguimos interpretar estruturalmente aquele valor.
A validade semântica virá depois.
Quarentena de arquivos
Objetos que não estão aptos não deveriam simplesmente desaparecer ou quebrar todo o pipeline.
Eles podem ser direcionados para uma quarentena de arquivos.
Ali podemos registrar:
objeto rejeitado;
motivo;
regra;
severidade;
execução;
origem;
evidências.
Quarentena não é lixo.
É parte do mecanismo de controle.
4. Estruturação do dado bruto — Bronze
O material foi preservado e aprovado.
Agora podemos transformá-lo em uma representação estruturada.
Entramos na Bronze.
A primeira camada formal
A Bronze procura responder:
O que efetivamente foi ingerido, de qual origem, em qual execução e sob qual contexto?
Ela normalmente transforma:
CSV → linhas e colunas
JSON → estruturas consultáveis
XML → representação processável
Parquet → representação tabular
Banco → registros persistidos
Mas precisa fazer isso preservando máxima fidelidade possível.
Bronze não significa dado ruim
Existe uma simplificação comum:
Bronze = dado ruimSilver = dado bom
Essa interpretação é inadequada.
A Bronze deve ser confiável como representação da origem.
Se a origem enviou:
cpf = ABC
uma Bronze correta pode registrar:
cpf = ABC
Isso significa que ela representou fielmente o que recebeu.
A validade do CPF é outra responsabilidade.
Transformações semanticamente neutras
Uma transformação como:
NOME CLIENTE
para:
nome_cliente
pode ser aceitável quando existe uma política de nomenclatura definida.
O significado continua o mesmo.
Agora:
status = 3
para:
status = Cliente inadimplente
já é diferente.
Estamos aplicando uma interpretação de negócio.
Isso não deveria ocorrer nessa etapa.
Granularidade
Outro ponto importante surge em dados semiestruturados.
Considere:
{
  "cliente_id": 123,
  "telefones": ["1111", "2222"]
}
O objeto original representa um cliente.
Se explodimos o array:
123 | 1111
123 | 2222
agora temos duas linhas.
Mudamos o grão.
Toda mudança de granularidade merece uma decisão consciente.
Histórico e append-only
Quando possível, Bronze deve favorecer comportamento historizado e append-only.
Mas:
append-only não significa duplicar cegamente cada reprocessamento.
É necessário distinguir:
nova ocorrência da origem
de
nova execução do mesmo material.
Novamente chegamos à idempotência.
5. Qualidade e padronização técnica — Silver Técnica
A Bronze representa bem aquilo que chegou.
Agora precisamos responder:
Esses registros são tecnicamente válidos para continuarem?
Aqui entra a validação técnica e, como resultado, a Silver Técnica.
Essa camada existe para corrigir e padronizar aspectos que independem da interpretação específica de negócio.
Schema e tipos
Validamos:
presença de campos;
tipos;
precisão;
escala;
nulabilidade;
comprimentos;
compatibilidade.
Conversões devem ser explícitas.
Imagine:
valor = "1.500,35"
Precisamos saber:
qual locale?
ponto é milhar?
vírgula é decimal?
qual precisão?
o que fazer se a conversão falhar?
Silenciosamente converter para zero seria uma péssima solução.
NULL não significa zero.
Da mesma forma:
string vazia não significa necessariamente NULL.
Cada transformação precisa possuir significado claro.
Datas
Datas são uma fonte frequente de erros.
Devemos tratar:
formato;
timezone;
precisão;
datas impossíveis;
datas fora da faixa permitida.
Também precisamos distinguir:
event time
do
processing time.
A transação pode ter ocorrido às 22:00 e sido processada às 22:10.
Esses tempos possuem significados distintos.
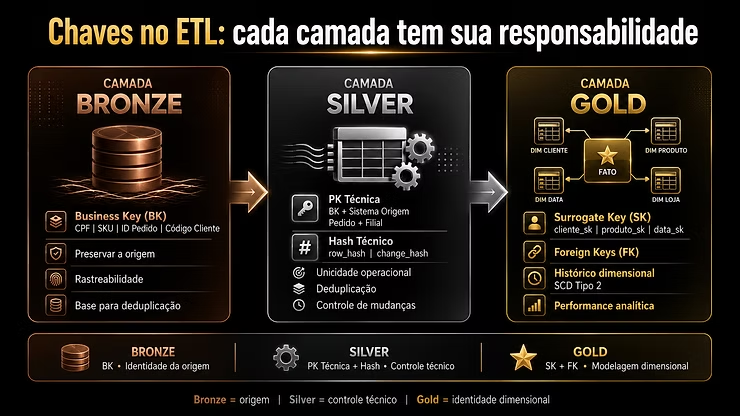
Identificadores
Precisamos distinguir:
Source Key;
Natural Key;
Business Key;
Surrogate Key;
Primary Key;
Foreign Key.
Usar um ID técnico gerado arbitrariamente como se ele representasse identidade de negócio é um erro arquitetural.
Hashes
Hashes podem ser utilizados para:
file hash;
row hash;
hash diff;
detecção de mudança;
deduplicação.
Mas existe um princípio importante:
hash não cria significado.
Um hash sobre colunas erradas apenas transforma uma definição errada em um identificador aparentemente sofisticado.
Deduplicação
Também precisamos definir o que é uma duplicidade.
Duas linhas completamente idênticas?
Mesmo Business Key?
Mesmo evento?
Mesmo arquivo reenviado?
Não existe deduplicação correta sem identidade bem definida.
Quarentena Técnica
Registros tecnicamente inválidos podem ser isolados.
Exemplos:
data inválida;
domínio incompatível;
campo obrigatório nulo;
identificador malformado;
tipo impossível de converter;
chave duplicada quando deveria ser única.
Dependendo da criticidade, podemos:
rejeitar o registro;
rejeitar o lote;
gerar warning;
permitir continuidade sob threshold.
A política precisa ser explícita.
Qualidade não deve ser apenas:
PASS / FAIL
Podemos trabalhar com severidades como:
INFO;
WARNING;
QUARANTINE;
ERROR;
FATAL.
Ao final dessa etapa temos algo importante:
um conjunto tecnicamente confiável, pronto para receber significado de negócio.
6. Transformação e integração das regras de negócio — Silver Analítica
Agora ocorre uma mudança fundamental.
Até aqui, perguntávamos:
O dado está tecnicamente correto?
Passamos a perguntar:
O que esse dado representa para a organização?
Entramos na Silver Analítica.
Regras de negócio
Aqui são apropriadas transformações como:
classificação;
derivação;
enriquecimento;
cálculos;
flags;
categorização;
conformidade;
hierarquias;
métricas intermediárias.
Retomando nosso exemplo:
Bronze:
status = 3
Silver Técnica:
status = 3
validando que 3 pertence ao domínio técnico.
Silver Analítica:
status_cliente = "inadimplente"
caso a regra corporativa determine que o código 3 possui esse significado.
Agora houve interpretação.
Integração
É também nessa etapa que dados de diferentes fontes começam a formar entidades analíticas.
Podemos integrar:
cliente;
conta;
produto;
contrato;
transação;
estabelecimento;
agência.
Isso envolve:
joins;
chaves;
resolução de identidade;
matching;
tabelas de referência;
consolidação de fontes.
Uma visão analítica frequentemente não existe em nenhum sistema de origem.
Ela é construída.
Padronização semântica
Imagine dois sistemas:
Sistema A:
M / F
Sistema B:
1 / 2
Uma camada analítica pode conformar ambos em um domínio corporativo.
Isso reduz a complexidade para quem consumirá posteriormente.
Histórico
Mudanças de negócio também precisam ser historizadas quando relevantes.
É aqui que conceitos como Slowly Changing Dimensions — SCD ganham importância.
Uma pergunta fundamental é:
Quero conhecer apenas o estado atual ou preciso saber o que era verdade em determinada data?
Sem essa definição, um modelo histórico facilmente produz resultados incorretos.
Regras precisam de versão
Uma regra não deveria existir apenas escondida dentro de:
CASE WHEN ...
Idealmente precisamos conhecer:
nome da regra;
descrição;
responsável;
versão;
data de vigência;
código;
dependências.
Por quê?
Porque regras mudam.
E quando mudam surge outra pergunta:
Os dados históricos devem permanecer como foram originalmente calculados ou precisam ser recalculados?
Essa resposta influencia diretamente o reprocessamento.
7. Qualidade analítica e preparação para publicação
O dado já está tecnicamente correto.
As regras de negócio foram aplicadas.
As fontes foram integradas.
Ainda assim, não significa que ele esteja pronto para consumo.
Agora precisamos verificar:
O resultado analítico está correto?
Esse é o papel da qualidade analítica.
Moses, Gavish e Vorwerck destacam justamente a necessidade de olhar para confiabilidade, testes, observabilidade, métricas de qualidade e SLAs como parte de um sistema de dados robusto, e não como medidas exclusivamente reativas.
Qualidade técnica e analítica são diferentes
Considere:
idade = 250
Talvez o tipo seja perfeitamente válido:
INTEGER
Logo, tecnicamente o registro pode ser legível.
Mas semanticamente:
idade = 250
provavelmente viola uma expectativa de negócio.
Esse é um excelente exemplo da diferença entre:
validade sintática/técnica
e
validade semântica/analítica.
O que devemos validar?
Métricas
soma;
média;
contagem;
saldo;
quantidade de clientes;
faturamento;
indicadores.
Integridade
relacionamentos;
cardinalidade;
órfãos;
granularidade.
Cobertura
O período esperado está completo?
Todos os estabelecimentos chegaram?
Todas as partições foram processadas?
Distribuição
Um valor que normalmente varia entre 10 e 15 milhões passou para 500 mil?
Isso pode ser tecnicamente válido e ainda indicar uma anomalia grave.
Reconciliação
Sempre que possível, dados podem ser reconciliados contra:
origem;
sistema oficial;
relatório contábil;
controle financeiro;
totalizadores.
Quality Gates
Uma arquitetura madura pode estabelecer condições formais para publicação.
Por exemplo:
critical_errors = 0
e:
rejected_records / total_records <= 0.1%
Isso transforma qualidade em uma decisão objetiva.
O sistema deixa de depender exclusivamente de alguém abrir um dashboard e perceber que alguma coisa parece estranha.
Quarentena Analítica
Assim como possuímos uma quarentena técnica, podemos ter uma quarentena analítica.
Um registro pode estar tecnicamente perfeito e ainda violar uma regra de negócio.
Exemplo:
data_fim < data_inicio
ou:
pagamento > valor_contrato
dependendo da semântica existente.
Manter essas quarentenas separadas é extremamente útil para diagnóstico.
A primeira aponta para problemas estruturais ou técnicos.
A segunda aponta para problemas de negócio ou interpretação.
8. Carga, modelagem e publicação para consumo — Gold
Finalmente chegamos à etapa que normalmente fica visível para os consumidores.
A camada Gold.
Mas existe uma diferença importante:
Gold não é simplesmente Silver com mais joins.
Gold deve existir a partir de casos de uso de consumo.
Começar pelas perguntas
Antes de modelar, precisamos entender:
quem vai consumir?
quais perguntas precisam ser respondidas?
qual granularidade?
quais filtros?
qual histórico?
qual latência?
qual performance?
Um modelo excelente tecnicamente pode ser péssimo se não responder às perguntas reais do usuário.
Modelagem dimensional
É aqui que a modelagem dimensional ganha grande importância.
Normalmente trabalhamos com:
tabelas fato
representando acontecimentos ou medições;
e
dimensões
representando contexto.
Exemplo:
fact_vendas
relacionada a:
dim_cliente
dim_produto
dim_tempo
dim_loja
Formando um Star Schema.
O grão primeiro
Antes de construir uma tabela fato, precisamos declarar seu grão.
Por exemplo:
Uma linha representa um item vendido dentro de uma transação.
ou:
Uma linha representa o saldo diário de uma conta.
Misturar granularidades é uma das formas mais eficientes de criar métricas inconsistentes.
Dimensões conformadas
Quando diferentes fatos utilizam as mesmas dimensões corporativas, conseguimos análises integradas.
dim_cliente
pode servir simultaneamente para:
vendas;
crédito;
atendimento;
marketing.
Isso cria consistência semântica entre diferentes áreas.
Data Marts
Data Marts podem organizar conjuntos de dados para domínios ou casos específicos.
Por exemplo:
Financeiro;
Comercial;
Risco;
Operações.
Mas um Data Mart não deve significar simplesmente duplicar qualquer tabela em uma pasta diferente.
Ele deve possuir:
propósito;
público;
semântica;
governança;
ownership.
Camada semântica
A Gold pode ser seguida ou complementada por uma camada semântica.
Aqui podemos centralizar:
métricas;
dimensões;
definições;
hierarquias;
regras de agregação.
Isso evita situações como:
Equipe A:
clientes_ativos = 10.500
Equipe B:
clientes_ativos = 12.300
porque cada área criou sua própria definição.
Performance
Publicação também significa experiência de consumo.
Precisamos pensar em:
particionamento;
clustering;
agregações;
materializações;
índices quando aplicáveis;
pruning;
caching;
estratégia de arquivos.
Um modelo correto que demora vinte minutos para responder a cada consulta continua sendo um produto ruim.
Segurança
Gold deve respeitar:
RBAC;
ABAC;
Row-Level Security;
Column-Level Security;
mascaramento;
classificação;
princípio do menor privilégio.
Nem todo campo disponível na Silver precisa chegar à Gold.
Data minimization deve ser considerada.
Dados como produto
Uma excelente forma de pensar Gold é:
o dado deixou de ser apenas um subproduto do pipeline e passou a ser um produto para alguém.
Esse produto precisa possuir:
consumidor;
owner;
contrato;
documentação;
SLA;
qualidade;
versão;
suporte;
ciclo de vida.
A literatura de qualidade de dados também aproxima confiabilidade da ideia de tratar dados como produto e distribuir responsabilidade pela qualidade ao longo da organização.
9. Observabilidade, rastreabilidade e reprocessamento
Pedagogicamente colocamos esta como a nona etapa.
Arquiteturalmente, porém, existe uma correção importante:
ela começa na etapa 1.
Observabilidade adicionada somente depois que o sistema entra em produção quase sempre será incompleta.
O mesmo vale para linhagem, metadados e reprocessamento.
Eles precisam ser desenhados desde o início.
Observabilidade: saber o que está acontecendo
Logs são importantes.
Mas logs, sozinhos, não significam observabilidade.
Precisamos observar múltiplas dimensões.
Execução
status;
duração;
retries;
falhas;
dependências.
Volume
quantidade de registros;
crescimento;
redução inesperada;
tamanho de arquivo.
Freshness
Quando o dado deveria chegar?
Quando efetivamente chegou?
Qualidade
registros rejeitados;
nulos;
duplicidades;
violações;
anomalias.
Performance
duração;
utilização de recursos;
throughput.
Disponibilidade
O dado está acessível no horário acordado?
Esse aspecto da confiabilidade é central na literatura de Data Quality, que aborda observabilidade, SLIs, SLOs e SLAs como mecanismos para tornar a saúde dos dados mensurável.
Rastreabilidade e linhagem: explicar o que aconteceu
Encontrar um dado incorreto na Gold deve permitir responder:
De onde esse valor veio?
Idealmente podemos navegar:
Dashboard
   ↓
Métrica
   ↓
Gold
   ↓
Silver Analítica
   ↓
Silver Técnica
   ↓
Bronze
   ↓
Landing
   ↓
Origem
Isso é linhagem.
Mas lineage possui vários níveis.
Dataset-Level
Mostra dependências entre tabelas.
Column-Level
Mostra de onde determinada coluna foi derivada.
Business Lineage
Explica conceitos e regras sob a ótica do negócio.
Runtime Lineage
Mostra o que efetivamente aconteceu em uma execução.
Provenance
Responde qual arquivo, lote, evento ou registro contribuiu para determinada informação.
Esses elementos tornam possíveis:
análise de impacto;
root cause analysis;
auditoria;
governança;
compreensão de mudança.
Metadados: o tecido que conecta as etapas
Grande parte dessa rastreabilidade depende de metadados.
Metadados não são apenas colunas começando por:
metadata
Podemos ter:
Técnicos
schema;
tipo;
partição.
Operacionais
run_id;
batch_id;
duração;
status.
Ingestão
origem;
timestamp;
watermark.
Arquivo
nome;
path;
checksum.
Qualidade
regra;
resultado;
severidade.
Negócio
descrição;
owner;
grain;
Business Key.
Governança
classificação;
criticidade;
retenção.
Linhagem
upstream;
downstream;
versão do código;
transformação.
Sem metadados, o dado pode continuar existindo fisicamente, mas perde contexto.
Reprocessamento: projetar para a falha
Em algum momento algo dará errado.
Não é pessimismo.
É engenharia.
Pode ocorrer:
bug;
atraso;
indisponibilidade;
mudança de regra;
dado corrigido;
schema drift;
falha de infraestrutura.
O problema não é admitir que falhas acontecerão.
O problema é não saber como recuperar.
Retry
Tentar novamente a mesma operação.
Replay
Reexecutar a partir de uma evidência preservada.
Reprocessing
Processar novamente determinado escopo.
Backfill
Preencher períodos históricos ausentes.
Repair Run
Executar uma correção direcionada depois que a causa é conhecida.
Full Refresh
Reconstruir todo o conjunto.
Full Refresh não deveria ser automaticamente a primeira estratégia de reparo.
Existe um princípio muito útil:
reprocessar o menor escopo possível.
Pode ser:
arquivo;
lote;
partição;
período;
Business Key;
entidade;
regra.
Isso reduz custo e risco.
Idempotência e determinismo
Nenhuma discussão séria sobre reprocessamento está completa sem esses dois conceitos.
Determinismo
Mesma entrada + mesmas regras + mesmo contexto
deveriam produzir:
mesmo resultado
Quando aplicável.
Um exemplo perigoso:
WHERE data <= CURRENT_DATE
ao reconstruir uma situação histórica.
Executar hoje e daqui a dois meses poderá produzir resultados diferentes.
Idempotência
Executar novamente uma operação não deveria introduzir efeitos indesejados.
Se processamos o mesmo arquivo duas vezes, não deveríamos automaticamente duplicar tudo.
Podemos resumir:
Determinismo pergunta:“O resultado será o mesmo?”
Idempotência pergunta:“Reexecutar causará efeitos adicionais indevidos?”
Konieczny dedica atenção específica a padrões de idempotência, incluindo overwrite, merge, keyed idempotency, transactional writer e immutable datasets, evidenciando a importância prática desse princípio em pipelines distribuídos.
Conceitos transversais: aquilo que não pertence a uma única camada
Nossa jornada possui nove etapas.
Mas existem elementos que atravessam todas elas.
Data Contracts
Contratos reduzem acoplamento implícito.
Eles podem definir:
schema;
tipos;
granularidade;
identidade;
domínios;
unidade;
temporalidade;
qualidade;
freshness;
volume;
segurança;
retenção.
A mudança de uma coluna pode ser pequena tecnicamente e enorme semanticamente.
Imagine:
valor
que antes representava reais e passa a representar centavos.
O tipo continua:
DECIMAL
O schema aparentemente não mudou.
Mas o contrato foi quebrado.
Schema Drift e evolução
Schemas mudam.
Novas colunas aparecem.
Campos são removidos.
Tipos são alterados.
Um pipeline maduro diferencia:
mudança compatível
de
breaking change.
Nem todo schema drift deve ser automaticamente aceito.
mergeSchema = true
pode ser conveniente.
Mas conveniência sem governança pode simplesmente propagar problemas para frente.
Governança
Governança não deveria ser uma burocracia adicionada ao final.
Ela existe para garantir:
ownership;
segurança;
classificação;
responsabilidade;
acesso;
retenção;
ciclo de vida.
Ela também ajuda a responder:
Quem é responsável por esse dado?
Essa pergunta é tão importante quanto:
Qual tabela contém esse dado?
Data Quality como característica contínua
Outro erro arquitetural recorrente é imaginar:
Pipeline
   ↓
Pipeline
   ↓
Pipeline
   ↓
Teste de qualidade no final
Qualidade precisa acontecer progressivamente.
Preflight
Qualidade do objeto.
Validação Técnica
Qualidade estrutural dos registros.
Validação Analítica
Qualidade semântica e de negócio.
Gold
Qualidade do produto publicado.
Observabilidade
Qualidade contínua em produção.
Essa estratégia reduz o blast radius.
Quanto antes detectamos um problema, menor tende a ser seu impacto.
Um pipeline executado com sucesso não significa dados corretos
Talvez essa seja uma das mensagens mais importantes deste artigo.
Imagine que:
o Airflow ficou verde;
o Databricks terminou com sucesso;
o dbt passou;
a tabela foi atualizada;
o dashboard abriu.
Ainda assim:
faturamento = 0
quando deveria ser:
faturamento = 25.000.000
Tecnicamente:
pipeline = SUCCESS
Analiticamente:
pipeline = FAILURE
Esse é exatamente o tipo de problema que torna qualidade e observabilidade elementos centrais de uma plataforma moderna.
Arquitetura Medalhão é o meio, não o objetivo
Bronze, Silver e Gold são extremamente úteis para organizar responsabilidades.
Mas simplesmente possuir tabelas chamadas:
bronze
silver
gold
não significa possuir uma arquitetura madura.
Podemos perfeitamente criar:
bronze_ruim
silver_ruim
gold_ruim
O valor não está no nome das camadas.
Está na fronteira de responsabilidade entre elas.
Uma boa arquitetura precisa deixar claro:
Landing
Preserva.
Bronze
Estrutura e registra historicamente.
Silver Técnica
Padroniza e valida tecnicamente.
Silver Analítica
Integra e interpreta.
Gold
Modela e publica.
Essa separação torna o sistema:
compreensível;
testável;
recuperável;
escalável;
auditável.
Serra mostra justamente como arquiteturas como Data Lakehouse e outras abordagens modernas devem ser entendidas dentro de um contexto mais amplo de decisões arquiteturais, e não como simples adoção de terminologia ou ferramentas.
A jornada completa
Podemos agora representar o processo inteiro:
FONTES
   │
   ▼
[1] Entendimento da origem
    estratégia, contrato, Full, Incremental, CDC
   │
   ▼
[2] Extração e ingestão
    captura, transporte, retries, metadados
   │
   ▼
[3] Landing
    preservação da evidência
   │
   ▼
Discovery
   │
   ▼
Preflight ─────────────► Quarentena de Arquivos
   │
   ▼
[4] Bronze
    estrutura, histórico, fidelidade
   │
   ▼
Validação Técnica ─────► Quarentena Técnica
   │
   ▼
[5] Silver Técnica
    padronização e consistência
   │
   ▼
[6] Silver Analítica
    integração e regras de negócio
   │
   ▼
[7] Validação Analítica ─► Quarentena Analítica
   │
   ▼
Quality Gate
   │
   ▼
[8] Gold
    fatos, dimensões, marts, métricas
   │
   ▼
Camada Semântica
   │
   ▼
BI / APIs / Analytics / ML / Data Products
E atravessando absolutamente tudo:
─────────────────────────────────────────────────────────
METADADOS • CONTRATOS • QUALIDADE • SEGURANÇA
GOVERNANÇA • OBSERVABILIDADE • LINEAGE
IDEMPOTÊNCIA • VERSIONAMENTO • REPROCESSAMENTO
─────────────────────────────────────────────────────────
Essa segunda linha é tão importante quanto a primeira.
O dado não fica melhor apenas porque atravessou mais camadas
Existe uma tentação perigosa em arquiteturas em camadas:
imaginar que a simples passagem de Bronze para Silver e de Silver para Gold aumenta automaticamente a qualidade.
Não aumenta.
O que aumenta a confiabilidade são controles explícitos.
Uma Gold pode estar errada.
Uma Silver pode estar errada.
Uma Bronze pode representar incorretamente a origem.
Uma Landing pode ter recebido um arquivo incompleto.
Por isso, o desenho precisa ser orientado por perguntas, contratos e evidências, e não apenas por nomes de camadas.
Do pipeline ao sistema de dados confiável
Ao final, podemos perceber uma mudança importante de mentalidade.
No início pensamos:
“Preciso levar esses dados da origem até uma tabela.”
Depois começamos a pensar:
“Preciso garantir que consigo reconstruir, explicar e confiar na informação produzida.”
Essa diferença separa um simples processo de movimentação de dados de uma verdadeira plataforma de dados.
Reis e Housley colocam justamente essa visão end-to-end no centro da Engenharia de Dados: o objetivo não é uma tecnologia específica, mas construir sistemas capazes de servir adequadamente aos consumidores de dados ao longo de todo o ciclo de vida.
Conclusão
ETL moderno não é apenas:
extrair, transformar e carregar.
É construir uma cadeia de confiança.
Começamos entendendo aquilo que queremos capturar.
Depois extraímos de forma controlada.
Preservamos a evidência recebida.
Validamos se ela pode ser processada.
Estruturamos sem alterar prematuramente seu significado.
Padronizamos tecnicamente.
Aplicamos regras de negócio.
Validamos semanticamente.
Modelamos para consumo.
E então continuamos observando, rastreando e garantindo capacidade de recuperação.
Essa jornada pode ser resumida em uma transformação:
dado existente
→ dado capturado
→ dado preservado
→ dado processável
→ dado tecnicamente confiável
→ dado com significado de negócio
→ dado analiticamente validado
→ dado publicado
→ dado continuamente confiável
E talvez a principal conclusão seja esta:
uma arquitetura de dados madura não é aquela que simplesmente consegue entregar dados quando tudo funciona.
É aquela que também consegue responder, quando algo dá errado:
O que aconteceu?
Onde aconteceu?
Quais dados foram afetados?
De onde eles vieram?
Qual regra produziu esse resultado?
Quem os consumiu?
Como podemos corrigir?
E como podemos reprocessar com segurança?
Quando conseguimos responder a essas perguntas, deixamos de construir apenas pipelines.
Passamos a construir sistemas de dados confiáveis.
Porque dado confiável não acontece por acaso.
Acontece por arquitetura, contratos, qualidade, observabilidade, processos e disciplina de engenharia.
Referências e leituras recomendadas
REIS, Joe; HOUSLEY, Matt. Fundamentals of Data Engineering: Plan and Build Robust Data Systems. O’Reilly Media.Uma referência para compreender a Engenharia de Dados como um ciclo de vida completo, contemplando geração, ingestão, armazenamento, transformação, consumo e preocupações transversais. A edição original foi publicada em 2022.
SERRA, James. Deciphering Data Architectures. O’Reilly Media.Apresenta e compara diferentes abordagens arquiteturais, incluindo Data Warehouse, Data Lake, Modern Data Warehouse, Data Lakehouse, Data Fabric e Data Mesh. Publicado originalmente em 2024.
KONIECZNY, Bartosz. Data Engineering Design Patterns. O’Reilly Media.Explora padrões aplicáveis à Engenharia de Dados, incluindo Full Load, Incremental Load, CDC, gerenciamento de erros, dados atrasados, deduplicação e idempotência. Publicado em 2025.
MOSES, Barr; GAVISH, Lior; VORWERCK, Molly. Fundamentos da Qualidade de Dados: Guia Prático para Criar Pipelines de Dados Confiáveis. O’Reilly / Novatec.Referência dedicada à construção de sistemas de dados confiáveis, abordando qualidade, testes, observabilidade, SLAs, linhagem e dados como produto.


Comentários