Modelagem dimensional da definição do grão à construção de fatos e dimensões confiáveis

Um modelo analítico precisa preservar o significado dos acontecimentos quando os dados são integrados, corrigidos, agregados e consultados ao longo do tempo. Para isso, cada linha deve representar algo definido, cada medida deve ter uma interpretação verificável e cada relacionamento deve levar ao contexto correto.
Uma consulta pode executar sem erros e entregar um resultado incorreto. Basta relacionar uma venda a duas versões do mesmo cliente, somar saldos de dias diferentes ou repetir o valor de um contrato em todas as suas parcelas. O banco processa essas operações; quem precisa impedir o erro conceitual é o modelo, acompanhado das regras de transformação e validação.
Neste artigo, desenvolvo a modelagem dimensional desde o raciocínio de negócio até sua implementação em uma plataforma moderna de dados. O percurso inclui star schema, fatos, dimensões, chaves substitutas, histórico, cargas, relacionamentos e testes. Os exemplos são fictícios. O objetivo é permitir que cada decisão seja explicada pelo significado dos dados e pelas perguntas que o modelo precisa responder.
1 O que estamos modelando
Modelar dados é estabelecer uma representação explícita de entidades, acontecimentos, propriedades e relações de um domínio. Essa representação inclui regras: o que identifica um cliente, quando uma venda passa a existir, como um cancelamento é reconhecido e qual classificação deve valer em uma análise histórica.
É útil separar três níveis. No modelo conceitual, identificamos os conceitos de negócio e seus vínculos: clientes compram produtos; contratos possuem parcelas; contas recebem lançamentos. No modelo lógico, definimos entidades ou tabelas, atributos, chaves, cardinalidades e regras temporais. No modelo físico, escolhemos tipos de dados, mecanismos de geração de chaves, organização de armazenamento e recursos do mecanismo de execução.
Uma regra como “uma parcela pertence a um contrato” é lógica. A decisão de armazenar sua chave em BIGINT é física. Escolher BIGINT não resolve uma ambiguidade sobre qual contrato a parcela representa.
Também precisamos distinguir finalidades. Sistemas transacionais, frequentemente chamados de OLTP, sustentam operações como cadastrar, contratar, pagar e cancelar. Modelos normalizados ajudam a controlar dependências e anomalias de atualização. Sistemas analíticos, associados a OLAP, precisam combinar, comparar e agregar acontecimentos sob diferentes perspectivas.
Modelagem dimensional é uma abordagem para essa finalidade analítica. Ela organiza os acontecimentos observáveis em fatos e seu contexto em dimensões. Continua sendo uma modelagem relacional quando implementada em tabelas; “dimensional” não significa abandonar chaves, integridade ou dependências funcionais.
Um warehouse, um lakehouse e uma arquitetura medalhão podem hospedar modelos dimensionais. São decisões em níveis diferentes: a arquitetura organiza capacidades e fluxos; o modelo define o significado e a organização lógica do dado consumido.
2 Começar pelo processo e pelas perguntas
Antes de examinar nomes de colunas, identifique o processo que será analisado. “Comercial” é uma área. “Venda de itens” é um processo. “Financeiro” é uma área. “Liquidação de parcelas” é um processo.
O método de Kimball organiza o desenho em quatro decisões: selecionar o processo, declarar o grão, identificar dimensões e identificar medidas. Essa sequência deve considerar tanto as necessidades de negócio quanto o que as fontes realmente conseguem fornecer. Processo de desenho dimensional em quatro etapas.
Considere uma empresa que precisa analisar vendas. “Quanto vendemos?” ainda é uma pergunta incompleta. É necessário estabelecer se venda significa pedido criado, pagamento confirmado, faturamento ou entrega. Também precisamos definir se o valor inclui descontos, frete, devoluções e tributos.
Imagine que pedido, pagamento e faturamento aconteçam em dias diferentes. Uma única coluna chamada "data" e uma única medida chamada "valor" não tornam esses conceitos equivalentes. Um modelo confiável explicita a data e o valor de cada processo, mantendo fatos separados quando os eventos têm granularidades distintas.
Uma especificação inicial pode ser curta, desde que seja precisa:
Decisão | Definição no exemplo |
Processo | Faturamento de itens vendidos |
Acontecimento | Item reconhecido em documento de faturamento |
Identidade | Sistema de origem, documento e número do item |
Momento analítico | Data e hora do faturamento |
Valor líquido | Valor bruto do item menos desconto do item |
Cancelamento | Evento de estorno com referência ao documento original |
Contexto histórico | Classificação do cliente vigente no faturamento |
Essas definições devem ser acordadas com quem conhece o processo. A engenharia pode detectar inconsistências e propor representações, mas não deve inventar o reconhecimento de receita ou a interpretação comercial de uma situação cadastral.
3 O grão define o significado de cada linha
Grão é a definição exata do que uma linha representa. Ele deve ser declarado antes da escolha das dimensões e medidas, pois ambas precisam ser compatíveis com essa unidade. O grão atômico corresponde ao menor nível disponível no processo observado, e agregações podem ser construídas a partir dele. Grão na modelagem dimensional.
Uma declaração adequada seria: “Uma linha representa um item de um documento de faturamento, identificado dentro de seu sistema de origem”. Dizer “a tabela tem cliente, produto e data” não define o grão. Um cliente pode comprar o mesmo produto várias vezes no mesmo dia, inclusive em duas linhas do mesmo documento.
No nosso exemplo, a chave lógica do acontecimento é (sistema_origem, documento, numero_item). As chaves de cliente, produto e calendário descrevem esse acontecimento, mas sua combinação não precisa ser única na fato.
Essa distinção evita um erro comum: deduplicar transações usando somente as FKs dimensionais. Duas compras legítimas podem possuir exatamente as mesmas FKs. Eliminá-las por essa combinação destrói acontecimentos reais.
O grão também controla o que pode ser armazenado como medida. Se um pedido tem três itens e frete total de R$ 30, repetir R$ 30 em cada item produz R$ 90 na soma. Existem alternativas: manter o frete em uma fato no grão do pedido ou distribuí-lo por uma regra explícita de rateio. Se o rateio for proporcional ao valor dos itens, os ajustes de arredondamento precisam garantir que as parcelas somem R$ 30.
A regra aplica-se a contratos e parcelas. O valor original de um contrato não deve ser interpretado como valor aditivo de cada parcela. Também se aplica a saldos: o saldo da conta no encerramento do dia não é uma medida do evento de pagamento que aconteceu naquele dia.
Uma medida candidata passa por uma pergunta objetiva: este valor pertence exatamente à unidade representada pela linha? Se a resposta exigir “depende”, falta especificar a regra ou criar outra estrutura.
4 Como o star schema organiza a análise
No star schema, ou esquema estrela, uma tabela fato se relaciona diretamente com dimensões. A fato registra acontecimentos ou estados mensuráveis, enquanto as dimensões fornecem os contextos usados em filtros e agrupamentos. Essa organização é uma recomendação importante também na construção de modelos semânticos de BI. Star schema na documentação da Microsoft.
Para o processo de vendas, podemos começar com esta estrutura:
Tabela | Unidade representada | Papel |
ft_venda_item | Um item faturado | Valores, quantidades e referências ao contexto |
dm_cliente | Uma versão analítica de um cliente | Segmento e outros atributos do cliente |
dm_produto | Um produto ou uma versão do produto | Nome, categoria e classificação |
dm_calendario | Um dia | Mês, ano e calendário de negócio |
dm_loja | Uma loja ou uma versão da loja | Unidade e localização da venda |
Uma linha de ft_venda_item guarda, por exemplo, sk_cliente = 101. A dimensão possui uma única linha com essa SK. Assim, muitas vendas podem apontar para a mesma linha dimensional, estabelecendo um relacionamento muitos para um da fato para a dimensão.
No modelo lógico pretendido, cada FK obrigatória encontra exatamente uma linha correspondente. Uma dimensão pode ter membros que ainda não aparecem em fatos; portanto, do ponto de vista de um membro dimensional, podem existir zero, uma ou muitas ocorrências na fato.
Uma implementação pode declarar PKs e FKs no banco, configurar relacionamentos no BI ou realizar joins no SQL. Esses mecanismos atuam em níveis diferentes. Um relacionamento configurado no BI não corrige duplicidades na dimensão armazenada, e um join SQL não prova que a associação respeita o contexto histórico.
O snowflake schema separa partes de uma hierarquia dimensional em outras tabelas: produto referencia subcategoria, que referencia categoria. No star schema, esses atributos costumam permanecer juntos na dimensão produto. A escolha envolve facilidade de consumo, manutenção e características do mecanismo; não deve ser reduzida a uma proibição de normalizar.
5 O que caracteriza uma tabela fato
Uma fato registra a ocorrência de um processo ou uma observação em um grão definido. Em geral, contém FKs dimensionais, medidas e, quando necessários, identificadores de documentos e timestamps. Sua estrutura é determinada pelo acontecimento observado. Estrutura de tabelas fato.
Uma tabela grande não é automaticamente uma fato. Um cadastro de clientes com cem milhões de linhas continua sendo cadastro. Da mesma forma, uma tabela pequena de metas mensais pode ser uma fato, pois representa valores definidos por período e contexto.

Fato transacional
A fato transacional representa ocorrências individuais, como um item faturado ou uma tentativa de pagamento. As linhas existem quando os acontecimentos são registrados; a ausência de linha não equivale automaticamente a uma medida zero. Fatos transacionais.
Uma tentativa e uma liquidação são eventos diferentes. Se uma transação passar por quatro mudanças de status, carregar cada mudança como se fosse uma nova liquidação multiplicará artificialmente a quantidade de pagamentos. É preciso decidir se a fato registra o ciclo de vida, o evento financeiro ou cada transição.
Fato de snapshot periódico
Um snapshot periódico observa um estado ou um conjunto de medidas em intervalos definidos. Exemplos incluem saldo por conta no fechamento diário e posição de estoque por produto, local e dia. A definição deve estabelecer quais entidades precisam aparecer mesmo sem movimentação. Snapshots periódicos.
Em uma tabela mensal, “setembro” ainda exige uma regra: último dia civil, último dia útil ou última posição recebida? Usar a última posição recebida sem informar sua data real pode apresentar um saldo de agosto como se fosse fechamento de setembro.
Fato de snapshot acumulativo
Um snapshot acumulativo acompanha uma instância de processo com marcos definidos. Uma proposta pode ter datas de criação, aprovação, assinatura e liberação. A linha é atualizada conforme o processo avança, permitindo medir duração entre etapas. Snapshots acumulativos.
Se a análise exigir todas as reaberturas ou retornos de etapa, uma única linha acumulativa pode ser insuficiente. Uma fato de eventos do processo preserva essas transições e pode coexistir com o snapshot.
Fato sem medidas numéricas
Uma factless fact table registra uma ocorrência ou associação mesmo sem valor monetário ou quantidade explícita. A presença de um aluno em uma aula é um exemplo. A contagem das linhas tem significado quando o grão está correto. Também é possível comparar uma cobertura esperada com ocorrências realizadas para identificar ausências. Fatos sem medidas.
Portanto, conter números não é condição suficiente nem necessária para uma tabela ser fato.
6 As medidas precisam de regras de agregação
As medidas podem ser aditivas, semiaditivas ou não aditivas. Uma medida aditiva pode ser somada ao longo das dimensões aplicáveis; uma semiaditiva admite soma em parte delas; uma razão geralmente exige recalcular o resultado a partir de seus componentes agregados. Aditividade das medidas.
No nosso exemplo, o valor líquido dos itens pode ser somado entre vendas, desde que os valores estejam em uma base monetária compatível e a política de estornos seja consistente. Já o saldo de uma conta de R$ 1.000 na segunda-feira e R$ 1.200 na terça-feira não significa R$ 2.200 disponíveis. Dependendo da pergunta, interessa o saldo de fechamento, a média dos saldos observados ou outra regra documentada.

A média também exige cuidado. Uma loja vende uma unidade por R$ 100; outra vende nove unidades por R$ 10. A média simples entre os preços médios das lojas é R$ 55. O preço médio por unidade vendida é R$ 19, obtido por R$ 190 divididos por dez unidades.
Por isso, para esse indicador, preservamos receita e quantidade e calculamos SUM(receita) / SUM(quantidade) no contexto desejado. Quantidades precisam estar na mesma unidade ou ser convertidas por uma regra explícita. Litros e unidades não se tornam somáveis por estarem na mesma coluna numérica.
Contagens distintas também são não aditivas entre conjuntos sobrepostos. Somar os clientes distintos de janeiro e fevereiro pode contar duas vezes quem comprou em ambos os meses. A identidade usada na contagem deve representar a entidade; contar SKs de versões SCD2 conta versões, não necessariamente clientes.
Zero, nulo e ausência de linha têm significados diferentes. Zero pode indicar uma medição válida sem valor. Nulo pode significar medida desconhecida ou não aplicável. Ausência de linha pode significar ausência de evento ou falha de cobertura. Substituir todos esses casos por zero elimina informação.
Para dinheiro, tipos decimais com precisão e escala definidas costumam ser apropriados. O contrato da medida deve explicitar moeda, arredondamento e momento da conversão. Uma coluna chamada valor sem essas definições deixa parte do modelo implícita.
7 Por que as descrições normalmente ficam nas dimensões
Nomes, categorias e descrições usados repetidamente como contexto analítico normalmente pertencem às dimensões. Isso centraliza sua interpretação, permite governar alterações e evita espalhar a mesma classificação por um grande volume de fatos.
Entretanto, “a fato não pode ter strings” é uma regra incorreta. O tipo físico da coluna não determina sua função no modelo. Um identificador de documento pode ser textual e permanecer na fato como dimensão degenerada: possui utilidade analítica, mas não exige uma tabela separada quando não há atributos próprios que justifiquem essa estrutura. Dimensões degeneradas.
O documento NF-2026-00158, por exemplo, pode agrupar seus itens e permitir rastreabilidade. Criar uma dimensão com uma SK e esse mesmo número, sem outro conteúdo ou necessidade, pode apenas acrescentar armazenamento e um join.
Timestamps e metadados operacionais também podem permanecer na fato. Campos como lote de carga ou referência de origem devem ter finalidade definida, podendo ser ocultados da camada semântica. Comentários longos, documentos e JSONs exigem uma decisão própria de consumo e armazenamento; não convém carregá-los automaticamente em todas as consultas de medidas.
O benefício de remover descrições repetitivas não é uma promessa universal de desempenho. Armazenamento colunar, compressão e leitura seletiva podem reduzir seu custo. Em certas cargas, uma tabela larga materializada pode ser eficiente. A avaliação física exige medições; a clareza semântica continua necessária em qualquer formato.
A pergunta adequada para cada campo é: ele mede o acontecimento, identifica o acontecimento, contextualiza a análise ou sustenta a operação do dado? A resposta orienta sua posição.
8 Como pensar e construir uma dimensão
Uma dimensão organiza o contexto pelo qual os fatos serão filtrados, agrupados e interpretados. Seus atributos podem ser nomes, classificações, localizações, códigos e características numéricas utilizadas descritivamente. Idade, capacidade e faixa de renda podem exercer papéis dimensionais; não são medidas aditivas apenas por serem números. Estrutura de tabelas dimensão.
O desenho começa pela entidade ou conceito e por seu grão. “Uma linha por cliente” descreve uma dimensão de estado atual. “Uma linha por versão histórica de cliente” descreve uma dimensão com histórico Tipo 2. São compromissos diferentes de identidade e unicidade.
Depois, selecionamos os atributos relevantes. Uma dimensão cliente pode conter código de origem, nome de exibição, município e segmento. Não deve virar uma cópia indiscriminada do cadastro, especialmente quando há atributos sensíveis sem finalidade analítica.
Os atributos também precisam de semântica temporal. “Idade atual” muda com o tempo, mesmo sem atualização cadastral. Para uma análise de idade na contratação, é necessário calcular a idade na data da contratação ou modelar uma faixa correspondente a esse evento, conforme a necessidade e as regras de privacidade. Gravar idade atual e interpretá-la como idade histórica produz um erro silencioso.
Uma dimensão costuma reunir hierarquias em uma estrutura achatada: produto, subcategoria e categoria; loja, município e estado. A repetição desses atributos entre membros é intencional e facilita o consumo. Dimensões desnormalizadas.
Isso não autoriza hierarquias incoerentes. Se a subcategoria pertence a uma única categoria no período considerado, o processo deve verificar essa dependência. Se pode pertencer a várias, o relacionamento precisa ser representado como tal.
O que precisa ser único
A SK deve identificar uma única linha da dimensão. Os atributos descritivos não precisam ser únicos. Vários clientes podem morar em Amargosa, ter o mesmo nome ou pertencer ao segmento Varejo. Proibir repetições nesses campos impediria representar o domínio corretamente.
sk_cliente | codigo_cliente | nome_exibicao | municipio | segmento |
101 | C42 | Cliente A | Amargosa | Varejo |
102 | C77 | Cliente B | Amargosa | Varejo |
103 | C88 | Cliente A | Salvador | Empresas |
As três linhas são válidas. O nome repetido não identifica a mesma pessoa, e a cidade repetida não representa duplicação de cliente. A dependência esperada é que uma SK determine os atributos daquela linha. O sentido inverso não é obrigatório.
Em uma dimensão SCD1 com uma linha por cliente, a chave de negócio canônica normalmente também é única. Em SCD2, ela se repete entre versões; a unicidade deve existir na identificação da versão e nas regras de vigência. Cada negócio pode ainda exigir restrições adicionais, mas elas precisam ser reais, não deduzidas de um nome de coluna.
SELECT DISTINCT elimina linhas iguais nas colunas selecionadas. Não resolve qual cadastro é verdadeiro, não estabelece identidade empresarial e não trata mudanças históricas. Se o cliente C42 aparece como Varejo e Premium, ambos os registros sobrevivem ao DISTINCT; é necessário saber quando cada classificação valeu e de qual fonte veio.
9 Chave natural chave de negócio chave durável e SK
Uma chave natural identifica algo no domínio ou no sistema de origem. Uma business key, ou BK, representa a identidade de negócio adotada pelo modelo. Os termos se sobrepõem na literatura; em uma implementação, convém documentar exatamente o que cada nome significa.
O código 42 pode ser único em um ERP e também existir em outro ERP para uma pessoa diferente. Nesse caso, a identidade de origem exige pelo menos (sistema_origem, codigo_cliente). Se o código só for único dentro de uma cooperativa ou empresa, esse escopo também precisa participar.
O prefixo de origem impede uma colisão entre códigos locais. Ele não identifica automaticamente que ERP_A/42 e CRM_B/900 são a mesma pessoa. Essa unificação exige regras de correspondência e, quando necessário, uma tabela que relacione identificadores de origem a uma identidade empresarial.
Uma chave durável preserva a identidade da entidade mesmo quando seus códigos operacionais mudam. Uma entidade pode ter uma chave durável e várias SKs, cada uma representando uma versão dimensional. Chaves naturais e duráveis.
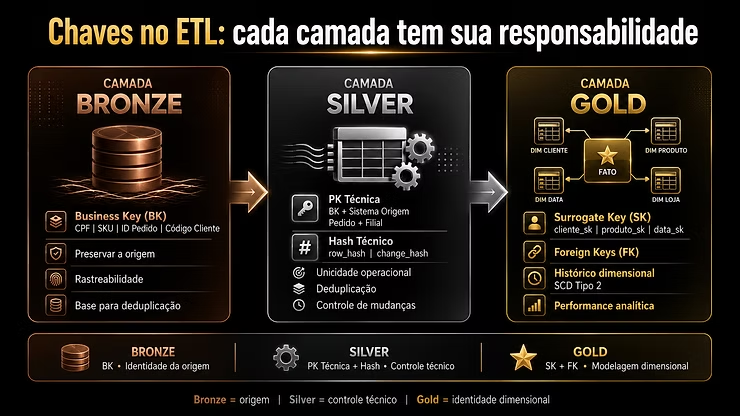
A surrogate key, ou SK, é um identificador técnico atribuído para identificar uma linha do modelo sem depender diretamente do identificador operacional. Na abordagem clássica de Kimball, utiliza-se uma chave inteira controlada pelo warehouse. Essa independência permite integrar fontes e representar várias versões históricas da mesma entidade. Chaves substitutas dimensionais.
Na dimensão, sk_cliente atua como chave primária. Na fato, a coluna que armazena esse valor atua como chave estrangeira. Não se gera outra SK de cliente para cada venda: resolve-se qual linha dimensional descreve a venda e copia-se sua chave para a fato.
Um hash da BK pode ser um identificador determinístico útil, mas não acrescenta conhecimento sobre a identidade. Se a BK estiver errada, seu hash também estará. Dar o nome bk_cliente a uma coluna SHA-256 não transforma o hash em uma regra de negócio; ele continua sendo uma representação técnica de determinados campos.
Convém preservar os componentes originais necessários à auditoria e ao tratamento de conflitos. A informação perdida por uma regra de normalização não pode ser recuperada a partir do hash.
10 Histórico dimensional e a identidade de cada versão
Slowly Changing Dimensions, ou SCD, reúne estratégias para tratar mudanças em atributos dimensionais. A estratégia deve ser escolhida conforme a interpretação que se deseja preservar.
No Tipo 0, conserva-se o valor original de um atributo definido como imutável para análise. No Tipo 1, atualiza-se o valor sem preservar sua versão anterior naquele atributo. Isso é apropriado, por exemplo, para corrigir um erro de grafia quando não há necessidade de analisar a grafia incorreta. Em dimensões híbridas, uma correção Tipo 1 pode precisar ser propagada às versões históricas afetadas. Atualizações Tipo 1.
No Tipo 2, uma mudança relevante cria uma nova linha com nova SK. As versões anteriores são preservadas, acompanhadas de vigência e, frequentemente, um indicador de versão atual. O fato deve referenciar a versão que representa seu contexto. Versionamento Tipo 2.
No exemplo, o cliente C42 passa de Varejo para Premium em 1º de julho de 2026:
SK | Cliente | Segmento | Início inclusivo | Fim exclusivo |
101 | C42 | Varejo | 2026-01-01 | 2026-07-01 |
205 | C42 | Premium | 2026-07-01 | Em aberto |
O intervalo é fechado no início e aberto no fim. Um evento exatamente em 1º de julho pertence à versão 205. A expressão de correspondência é instante_evento >= inicio_vigencia e instante_evento < fim_vigencia, tratando o fim em aberto conforme a convenção escolhida.
Usar BETWEEN com dois limites inclusivos faria o instante de transição encontrar as duas linhas. Se a origem registra várias mudanças no mesmo dia, campos DATE podem ser insuficientes: precisamos de timestamp e de uma ordenação de mudanças que desfaça empates.
is_current deve ter uma definição precisa. Neste exemplo, significa “versão final com fim em aberto”. Com alterações futuras agendadas, a última versão conhecida pode ainda não estar vigente no relógio atual. Para responder “qual versão vale agora?”, deve-se avaliar o intervalo temporal, não presumir que todo indicador de última versão representa a situação presente.
Tempo do negócio e tempo do sistema
A vigência de negócio responde quando o atributo passou a valer no mundo representado. O tempo de processamento responde quando a plataforma recebeu ou registrou a informação. Esses momentos podem ser diferentes.
Se uma mudança válida desde julho só chega em agosto, usar agosto como início cria uma história de conhecimento da plataforma, não necessariamente a história do negócio. Quando precisamos responder tanto “o que era válido?” quanto “o que sabíamos naquela data?”, um único intervalo SCD2 não basta. É necessário representar também o tempo de registro, em uma abordagem bitemporal ou equivalente.
O histórico disponível também impõe um limite. Se a fonte só fornece o cadastro atual e a captura começou hoje, não é possível reconstruir com certeza todos os estados anteriores. A data da primeira observação não deve ser apresentada como data comprovada de início do atributo no negócio.
O hash de mudança não é a chave da versão
O hash_diff resume os atributos que devem provocar uma nova versão. Ele serve para detectar mudanças em relação à versão de referência. Deve excluir metadados que variam a cada execução, como horário de carga, e respeitar a política Tipo 1 ou Tipo 2 de cada atributo.
Se o segmento de C42 seguir a sequência Varejo, Premium e Varejo, o primeiro e o terceiro estado podem ter o mesmo hash_diff. Ainda assim, representam períodos distintos e precisam de identidades de versão distintas.
Essa é a razão pela qual hash(BK, atributos) não é, sozinho, uma identificação segura de versão histórica. É necessário distinguir a ocorrência da versão, usando uma SK atribuída ou um identificador estável de início de versão, com regras para correções retroativas.
11 Como criar SKs em uma plataforma moderna
A escolha deve considerar estabilidade, unicidade controlada, concorrência, custo de joins e recuperação. A pergunta principal é se a estratégia preserva o vínculo entre a fato e a linha dimensional ao longo das cargas.
Inteiros atribuídos e persistidos
Uma sequência, uma coluna identity ou um alocador coordenado pode atribuir uma nova chave a cada novo membro ou versão. O mapeamento precisa ser persistido. Uma SK não precisa ser consecutiva nem ter significado; lacunas na sequência são aceitáveis.
MAX(sk) + ROW_NUMBER() é perigoso com escritores concorrentes: dois processos podem observar o mesmo máximo e gerar valores sobrepostos. Recalcular ROW_NUMBER() sobre toda a dimensão a cada carga também pode renumerar membros existentes. O resultado é uma fato que continua apontando para números válidos, porém associados a outras linhas.
Em tabelas Delta no Databricks, a documentação consultada informa que colunas identity usam BIGINT e não suportam transações concorrentes na tabela. Logo, esse recurso precisa ser compatível com a estratégia de escrita escolhida. Essas características são específicas da plataforma e devem ser verificadas na versão utilizada. Colunas identity no Databricks.
Uma sequência local também não garante a mesma SK em desenvolvimento e produção. Se arquivos de fatos forem transferidos entre ambientes, os mapeamentos dimensionais precisam acompanhar os dados ou as FKs devem ser resolvidas novamente.
Chaves determinísticas com hash
Hashes permitem derivar um identificador dos mesmos componentes sem consultar um contador central. Ferramentas modernas adotam esse padrão, mas sua estabilidade depende da serialização e da distinção entre valores nulos, vazios e combinações diferentes de campos. Geração de chaves no dbt.
Concatenar 12 e 345 sem uma representação inequívoca produz a mesma string que concatenar 123 e 45. Um separador simples também pode aparecer dentro dos valores. Uma serialização precisa definir ordem, tipos, escape, nulos, precisão e fuso horário.
No Databricks, xxhash64 retorna um BIGINT, e os tipos dos argumentos afetam o resultado. Casts explícitos e um contrato estável de entrada são necessários quando a chave será reproduzida em cargas diferentes. Função xxhash64.
Um exemplo didático para uma identidade de origem validada e sem componentes nulos é:
-- Exemplo de hash de identidade de origem para SCD1.
-- Os campos já devem estar normalizados por regras de negócio.
xxhash64(
    CAST(sistema_origem AS STRING),
    CAST(codigo_cliente AS STRING)
)
A expressão não garante unicidade matemática. Também não distingue versões SCD2 do mesmo cliente. Para uma chave determinística de versão, seria necessário incluir um identificador estável da versão, por exemplo um ID de mudança da origem com escopo adequado. Um timestamp de vigência só serve se distinguir versões e tiver política definida para correções.
Se o início de vigência participar da SK e for corrigido depois, o hash mudará. As referências existentes precisarão ser migradas, ou será necessário preservar uma identidade de versão independente desse timestamp. Esse custo deve ser considerado antes de adotar a fórmula.
Colisões e tamanho da chave
Uma função de hash com saída finita permite colisões: duas entradas distintas podem produzir o mesmo resultado. Para uma distribuição ideal de 64 bits, a aproximação do problema do aniversário resulta em cerca de 0,027% de chance de ao menos uma colisão com 100 milhões de entradas distintas e cerca de 2,67% com um bilhão. São estimativas matemáticas, não medições de uma carga específica.
Uma representação SHA-256 tem um espaço muito maior, mas também ocupa mais bytes: 32 em binário ou 64 caracteres em hexadecimal antes dos efeitos do armazenamento. Transformar esse resultado em 64 bits volta a limitar o espaço a 64 bits.
Não se deve aplicar ABS apenas para deixar o hash positivo: isso pode fazer valores positivos e negativos convergirem e ainda exige atenção ao menor inteiro assinado. Valores negativos são válidos como identificadores técnicos quando o contrato os permite.
Se a estratégia usar hash como chave, é preciso detectar colisões contra as identidades originais e definir a ação: impedir a publicação, registrar exceção e usar um mapeamento controlado. A mesma regra vale para valores reservados, como -1, que não podem ser presumidos impossíveis na saída do hash.
Critério de escolha
Estratégia | Vantagem | Responsabilidade principal |
Inteiro atribuído | Chave compacta e identidade independente dos atributos | Coordenar geração e preservar o mapeamento |
Hash determinístico | Reprodução a partir das mesmas entradas | Canonicalização, colisões e identidade da versão |
UUID | Geração distribuída com espaço amplo | Persistência, custo físico e política de geração |
UUID aleatório não é reproduzível a partir da BK; regenerá-lo em cada carga quebra referências. Chave sequencial não é obsoleta, e hash não é automaticamente superior por ser comum em pipelines distribuídos. Para dimensões consumidas em joins recorrentes, inteiros persistidos continuam sendo uma escolha forte quando a plataforma e a operação sustentam sua geração.
12 O relacionamento correto entre fato e dimensão
Considere duas vendas de C42. A primeira ocorreu em 15 de junho, por R$ 800; a segunda, em 15 de agosto, por R$ 200. Os demais contextos foram omitidos para isolar o relacionamento com cliente.
Evento | Data | SK do cliente | Valor líquido |
V001 | 2026-06-15 | 101 | 800,00 |
V002 | 2026-08-15 | 205 | 200,00 |
O resultado histórico correto é Varejo = R$ 800 e Premium = R$ 200. O total é R$ 1.000.
Durante a carga, a BK identifica o cliente e a vigência identifica sua versão. Depois da resolução, a fato armazena a SK. Esse processo costuma ser chamado de lookup dimensional ou resolução de chaves.
O exemplo a seguir pode ser executado em Spark SQL ou Databricks SQL. Cria apenas views temporárias e demonstra a resolução; não constitui um pipeline de carga completo.
CREATE OR REPLACE TEMP VIEW ex_dm_cliente AS
SELECT * FROM VALUES
  (101L, 'ERP_A', 'C42', 'Varejo',
   TIMESTAMP '2026-01-01 00:00:00',
   TIMESTAMP '2026-07-01 00:00:00'),
  (205L, 'ERP_A', 'C42', 'Premium',
   TIMESTAMP '2026-07-01 00:00:00',
   CAST(NULL AS TIMESTAMP))
AS d(sk_cliente, sistema_origem, codigo_cliente,
     segmento, inicio_vigencia, fim_vigencia);

CREATE OR REPLACE TEMP VIEW ex_venda_origem AS
SELECT * FROM VALUES
  ('V001', 'ERP_A', 'C42',
   TIMESTAMP '2026-06-15 10:00:00',
   CAST(800.00 AS DECIMAL(18,2))),
  ('V002', 'ERP_A', 'C42',
   TIMESTAMP '2026-08-15 10:00:00',
   CAST(200.00 AS DECIMAL(18,2)))
AS v(id_evento, sistema_origem, codigo_cliente,
     instante_evento, valor_liquido);

CREATE OR REPLACE TEMP VIEW ex_resolucao AS
SELECT
    v.id_evento,
    v.instante_evento,
    v.valor_liquido,
    d.sk_cliente
FROM ex_venda_origem v
LEFT JOIN ex_dm_cliente d
  ON v.sistema_origem = d.sistema_origem
 AND v.codigo_cliente = d.codigo_cliente
 AND v.instante_evento >= d.inicio_vigencia
 AND (
      v.instante_evento < d.fim_vigencia
      OR d.fim_vigencia IS NULL
 );

-- Cada evento deve encontrar exatamente uma versão.
-- Neste exemplo, a consulta deve retornar zero linhas.
SELECT id_evento
FROM ex_resolucao
GROUP BY id_evento
HAVING COUNT(*) <> 1
    OR COUNT(sk_cliente) <> 1;
O LEFT JOIN preserva evidência de ausência de correspondência. Um INNER JOIN nessa etapa poderia eliminar silenciosamente um evento sem dimensão. A etapa seguinte só deve publicar os registros depois de aplicar a política de tratamento de ausências e ambiguidades.
A consulta analítica já utiliza a SK resolvida:
SELECT
    d.segmento,
    SUM(f.valor_liquido) AS valor_liquido
FROM ex_resolucao f
JOIN ex_dm_cliente d
  ON f.sk_cliente = d.sk_cliente
GROUP BY d.segmento;
Relacionar diretamente a origem com a dimensão apenas por codigo_cliente faria cada venda encontrar as duas versões. O resultado seria quatro linhas e R$ 2.000. Acrescentar o sistema de origem resolve colisões de escopo, mas não resolve essa duplicação temporal.
Outro erro é acrescentar is_current = true ao join entre uma fato historicamente resolvida e sua dimensão. A venda antiga continua apontando para SK 101, cuja versão já terminou. O filtro de atualidade a excluiria, deixando apenas R$ 200.
Para analisar todo o histórico pela classificação atual, é necessário oferecer explicitamente essa perspectiva: associar a identidade durável da entidade à sua classificação atual, por uma estrutura ou camada semântica apropriada. É uma pergunta diferente da classificação na data do evento, e ambas podem ser necessárias.
13 Um processo consistente para carregar dimensões
Uma dimensão confiável depende de um processo que preserve identidade, precedência de fontes e tempo. Extrair atributos, executar DISTINCT e gerar números não é suficiente.
Começamos validando o escopo da BK. Códigos vazios, identificadores incompletos e conflitos entre fontes precisam ser classificados. Em seguida, normalizamos apenas o que o domínio permite: remover zeros de um código ou acentos de um nome pode destruir informação. O valor original pode ser preservado separadamente da representação padronizada.
A precedência entre registros deve ser determinística. Se duas linhas representam a mesma atualização, podemos eliminar a duplicata técnica. Se representam duas mudanças legítimas, devemos preservá-las. Para construir SCD2 a partir de CDC, selecionar somente a última mudança do lote perde estados intermediários que podem ser necessários para relacionar fatos ocorridos entre essas mudanças.
CDC, ou captura de alterações, transporta evidências de inserções, atualizações e exclusões. Ele não decide, sozinho, qual atributo requer histórico analítico, qual versão deve ser relacionada a uma venda ou se uma correção retroativa precisa reclassificar fatos.
Depois de ordenar as mudanças, comparamos os atributos relevantes com o estado precedente. Em SCD1, uma mudança autorizada atualiza atributos e mantém a SK. Em SCD2, uma mudança real fecha a vigência anterior e cria uma linha com nova SK. Registros sem mudança não devem gerar versões artificiais.
Uma implementação precisa preservar atomicidade entre fechamento e criação da versão. Quando o mecanismo não oferece a transação desejada entre etapas, o desenho deve adotar outra forma de publicação consistente, como um conjunto preparado de alterações ou uma troca controlada da saída. Duas instruções executadas separadamente não devem ser presumidas atômicas.
Para uma entidade ativa em uma linha temporal simples, os invariantes esperados incluem:
SK preenchida e única em toda a dimensão;
identificação de versão única dentro da entidade;
início anterior ao fim, quando houver fim;
ausência de intervalos sobrepostos para a mesma identidade;
no máximo uma versão com fim em aberto;
preservação das SKs já referenciadas, salvo migração deliberada e coordenada.
Nem toda entidade precisa ter uma versão aberta: uma entidade encerrada pode ter apenas versões finalizadas. Da mesma forma, continuidade sem lacunas é uma regra de negócio possível, mas não deve ser imposta a domínios em que o vínculo deixa de existir por determinados períodos.
Se a extração for incremental, a ausência de uma entidade no lote não significa exclusão. Expirar ausentes só é válido quando a entrada representa uma fotografia completa e confiável da população esperada, ou quando há um evento explícito de exclusão.
14 Dados atrasados desconhecidos e correções retroativas
Um fato pode chegar depois de sua data de ocorrência. Nesse caso, a resolução precisa encontrar a versão histórica apropriada; relacioná-lo sempre à versão mais recente altera o significado do evento. Fatos que chegam atrasados.
Também pode acontecer o inverso: a venda chega antes do cadastro do cliente. Existem políticas distintas. Podemos suspender a publicação, publicar com um membro especial ou criar um membro inferido, com a BK conhecida e os atributos ainda não disponíveis. Quando o cadastro chegar, esse membro pode ser completado conforme a regra de histórico. Dimensões que chegam atrasadas.
Um membro genérico “Desconhecido” e um membro inferido resolvem necessidades diferentes. O primeiro agrupa ausências. O segundo preserva a identidade individual já conhecida. Se cem clientes forem associados ao mesmo desconhecido, contar a SK desse membro não permitirá descobrir quantos clientes eram.
Os valores reservados precisam existir fisicamente na dimensão. Por exemplo, -1 pode representar desconhecido e -2, não aplicável, desde que a estratégia de geração impeça conflitos. “Cliente não se aplica a este evento” é diferente de “deveríamos conhecer o cliente, mas ainda não o identificamos”.
Usar COALESCE(sk_cliente, -1) sem registrar o motivo pode esconder falhas recorrentes. O tratamento precisa deixar rastros suficientes para resolver o vínculo posteriormente, medir a taxa de desconhecidos e reconciliar os valores publicados.
Uma correção retroativa exige ainda mais cuidado. Suponha que a mudança de C42 para Premium, antes registrada em 1º de julho, seja corrigida para 20 de junho. Os fatos entre 20 e 30 de junho podem precisar de novas FKs. Corrigir somente a dimensão deixa essas vendas associadas à versão errada.
Portanto, uma manutenção histórica deve avaliar o intervalo afetado, ajustar versões e reprocessar as referências impactadas. Se o requisito for preservar o relatório tal como era conhecido antes da correção, precisamos também manter a perspectiva de tempo de registro discutida anteriormente.
15 A fato também precisa de identidade e política de atualização
Uma SK própria da fato pode facilitar rastreabilidade ou operações de manutenção, mas não é requisito universal do modelo dimensional. Ela também não substitui a definição do grão. Chave substituta em tabelas fato.
No exemplo de faturamento, a identidade lógica é (sistema_origem, documento, numero_item). Se houver estornos como eventos independentes, a identidade deve distinguir o evento de estorno do item original. Uma chave técnica nova em cada execução não evita duplicação: permite gravar novamente o mesmo acontecimento com outro número.
Idempotência significa que repetir a mesma entrada, segundo o contrato de processamento, não cria efeitos indevidos adicionais. Para uma fato, isso exige identificar o evento e definir o que fazer quando ele reaparece igual, corrigido ou cancelado.
Há modelos que atualizam um evento corrigido e modelos que preservam eventos compensatórios. A decisão depende do processo e das exigências de auditoria. Uma tabela append-only não é automaticamente correta se a origem reenviar o mesmo evento; um MERGE também não é automaticamente correto se a chave usada para correspondência estiver incompleta.
Antes de persistir a fato, validamos seu grão, resolvemos todas as dimensões necessárias, verificamos a multiplicidade de cada lookup e reconciliamos as medidas. Quando um join deveria somente acrescentar contexto, a quantidade de eventos e seus valores precisam permanecer explicáveis antes e depois da operação.
Uma carga completa não deve recriar as dimensões com novas SKs e manter as fatos antigas. Reconstruções exigem preservar o mapeamento ou reconstruir as referências de forma coordenada. A capacidade de reprocessar depende tanto do histórico da fonte quanto da estabilidade das identidades analíticas.
16 Dimensões compartilhadas calendário e papéis
Uma dimensão conformada possui significado e domínio compatíveis entre processos. Sua função é permitir comparações coerentes entre fatos diferentes. Reutilizar o nome dm_cliente em dois projetos não garante conformidade se cada projeto identifica e classifica clientes de maneira diferente. Dimensões conformadas.
Uma matriz simples ajuda a planejar esse compartilhamento:
Processo | Calendário | Cliente | Produto | Loja |
Faturamento de itens | Sim | Sim | Sim | Sim |
Recebimento de pagamentos | Sim | Sim | Conforme alocação | Conforme regra |
Estoque diário | Sim | Não | Sim | Sim |
Meta mensal por loja | No grão mensal | Não | Conforme a meta | Sim |
“Conforme alocação” significa que o contexto não pode ser inventado. Um pagamento de pedido com vários produtos não pertence integralmente a cada produto. É necessária uma regra de distribuição ou uma análise em outro nível.
A dimensão calendário reúne atributos como ano, mês e períodos fiscais. É uma exceção comum ao uso estrito de chaves opacas: uma chave 20260916 pode representar o dia 16 de setembro de 2026. Ainda assim, deve existir uma coluna de data e tratamento para membros especiais. Dimensão calendário.
Uma data de dia não deve ser usada artificialmente para representar uma meta mensal sem uma regra clara. Pode-se usar uma dimensão de mês ou outra estrutura com grão e relacionamento compatíveis. Chaves numéricas no formato yyyyMMdd também não devem ser subtraídas para calcular duração.
Uma mesma dimensão pode desempenhar papéis diferentes. Uma fato de processo pode ter sk_data_criacao, sk_data_aprovacao e sk_data_liquidacao, todas referenciando o calendário. Cada vínculo possui significado próprio. Essa técnica é conhecida como role-playing dimension. Dimensões com múltiplos papéis.
A data local de negócio deve ser calculada considerando o fuso e a regra do evento. Converter um timestamp UTC diretamente para data pode classificar uma ocorrência noturna no dia incorreto para a operação local.
17 Relacionamentos muitos para muitos e combinações de fatos
O relacionamento simples de uma fato para uma dimensão pressupõe uma linha dimensional por referência. Há domínios em que um acontecimento possui vários participantes: um contrato com dois titulares ou uma venda atribuída a dois consultores.
Uma tabela ponte, ou bridge table, pode representar esse vínculo. Ela precisa definir grão, unicidade e, quando o relacionamento muda, vigência. Uma junção por essa ponte expande linhas; portanto, a regra de medida deve acompanhar o relacionamento. Dimensões multivaloradas e pontes.
Considere um contrato de R$ 100.000 com dois participantes. Se o indicador mede atribuição econômica e a regra é 60% para um e 40% para outro, o valor atribuído pode ser calculado como valor do contrato vezes o peso. Os pesos devem somar 1 para o conjunto aplicável.
Se o indicador mede exposição de cada participante ao contrato inteiro, ambos podem receber R$ 100.000 em sua análise individual. Nesse caso, a soma entre participantes não representa o volume único contratado. O modelo semântico deve impedir que essa soma seja interpretada como se representasse.
Flags independentes de baixa cardinalidade podem ser agrupadas em uma junk dimension, evitando muitas dimensões minúsculas. Por exemplo, origem promocional e modalidade assistida podem formar combinações analíticas. É possível materializar apenas as combinações observadas, sem gerar um produto cartesiano desnecessário. Junk dimensions.
Por que juntar duas fatos pode multiplicar valores
Imagine que C42 tenha três itens faturados e dois pagamentos. Um join entre as duas fatos apenas pelo cliente gera seis combinações. Cada valor de item aparece duas vezes; cada pagamento, três.
Para comparar processos independentes, agregamos cada fato ao nível comum desejado e relacionamos os resultados por dimensões conformadas. Essa abordagem é conhecida como drill-across ou consulta em múltiplas passagens. Consultas entre fatos, Drill-across.
Se a comparação for mensal por cliente, os dois lados devem ter no máximo uma linha por mês e identidade de cliente compatível. Para incluir meses presentes apenas em um processo, pode ser necessário um FULL OUTER JOIN. Isso não elimina a obrigação de definir se mês significa faturamento ou recebimento.
Um join direto entre fatos pode ser legítimo quando a relação entre eventos e sua cardinalidade estão demonstradas. A restrição é contra o uso de uma associação muitos para muitos sem controle, não contra toda combinação de tabelas que tenham o prefixo ft_.
18 Integridade e testes que protegem o significado
Um modelo só se torna confiável quando suas regras são verificadas nas cargas. A documentação do Databricks informa que PKs e FKs são restrições informacionais, sem imposição automática de unicidade e integridade referencial. O uso de RELY pode permitir otimizações baseadas nessas declarações; se forem falsas, consultas podem produzir resultados incorretos. Restrições no Databricks.
A verificação precisa abranger tanto a estrutura quanto o significado:
Regra | Falha que procura |
SK não nula e única | Uma referência encontra nenhuma ou várias linhas |
Grão único na fato | O mesmo acontecimento foi carregado duas vezes |
FK existente | O fato aponta para um membro inexistente |
Vigências sem sobreposição | Um evento encontra duas versões |
Correspondência temporal válida | A FK aponta para versão fora do instante do evento |
Reconciliação de medidas | Perda ou multiplicação de valor na transformação |
Domínios válidos | Classificações incompatíveis com o contrato |
Idempotência | Reexecução produz novos eventos ou versões indevidos |
Cobertura e atualidade | Falta de dados é confundida com ausência de atividade |
As consultas abaixo são ilustrativas e pressupõem as colunas apresentadas. Retornar zero linhas é o resultado esperado para as regras verificadas.
-- Duplicidade de SK na dimensão.
SELECT sk_cliente, COUNT(*) AS quantidade
FROM dm_cliente
GROUP BY sk_cliente
HAVING COUNT(*) > 1;

-- FKs inexistentes, incluindo nulos indevidos.
SELECT f.id_evento, f.sk_cliente
FROM ft_venda_item f
LEFT JOIN dm_cliente d
  ON f.sk_cliente = d.sk_cliente
WHERE d.sk_cliente IS NULL;

-- Sobreposição entre versões da mesma identidade.
-- Fim nulo representa intervalo em aberto.
SELECT
    a.sk_cliente AS versao_a,
    b.sk_cliente AS versao_b
FROM dm_cliente a
JOIN dm_cliente b
  ON a.sistema_origem = b.sistema_origem
 AND a.codigo_cliente = b.codigo_cliente
 AND a.sk_cliente < b.sk_cliente
 AND (a.inicio_vigencia < b.fim_vigencia
      OR b.fim_vigencia IS NULL)
 AND (b.inicio_vigencia < a.fim_vigencia
      OR a.fim_vigencia IS NULL);
A regra de SK não nula deve ser verificada separadamente da primeira consulta. A validação de intervalos também pressupõe inícios preenchidos e intervalos individualmente válidos, que exigem seus próprios testes. Em grande volume, a detecção de sobreposição pode ser implementada com funções de janela, desde que também detecte intervalos aninhados.
Contagem e soma total não bastam isoladamente. Um evento perdido e outro duplicado de mesmo valor podem manter o total. A reconciliação deve combinar identidade de eventos, distribuição por recortes relevantes e medidas. Diferenças permitidas, como arredondamentos, precisam ter tolerâncias documentadas.
Os casos de borda merecem testes específicos: evento no limite entre versões; cliente que volta ao segmento anterior; duas alterações no mesmo instante; dado atrasado; código reutilizado; lote repetido; exclusão informada pela origem. São esses casos que revelam se o contrato continua válido além da carga inicial.
19 Como o modelo se encaixa nas camadas de dados
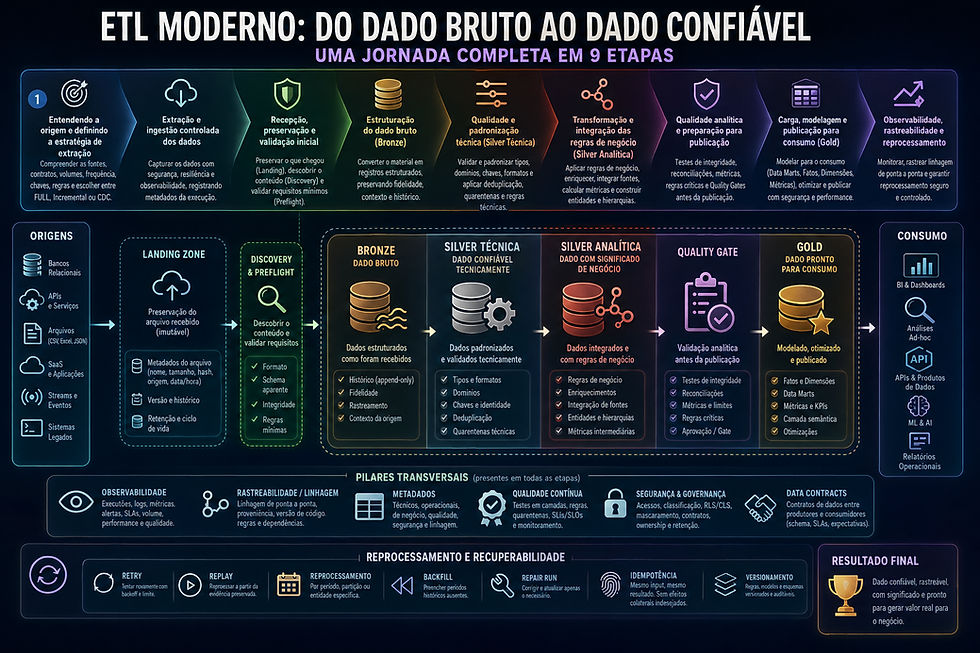
Em uma arquitetura com landing, bronze, silver e gold, cada camada pode assumir uma responsabilidade. O desenho exato varia por organização; os nomes não impõem um esquema universal.
Uma implementação possível preserva arquivos e eventos recebidos na landing e bronze, trata tipos, identidade e qualidade na silver e publica modelos de consumo na gold. Pode existir uma silver analítica para integrações reutilizáveis antes dos produtos finais.
A decisão de historizar uma entidade na silver não elimina a necessidade de escolher quais versões e atributos a dimensão gold representará. Uma dimensão pode combinar várias entidades de origem ou aplicar uma política de histórico diferente. Reutilizar a SK da silver só faz sentido se identidade, grão, estabilidade e semântica temporal forem compatíveis e governados.
Da mesma forma, chamar uma tabela de gold não a transforma em fato, e chamar uma tabela de silver não exige SCD2. Eventos podem ser preservados de forma incremental; cadastros podem usar estado atual; estados históricos podem atender a requisitos específicos. A estratégia decorre da necessidade de informação.
Reis e Housley apresentam a engenharia de dados como um ciclo de vida que inclui geração, ingestão, transformação, armazenamento e atendimento ao consumidor, atravessado por preocupações como governança e segurança. Esse enquadramento ajuda a situar a modelagem como parte de um sistema completo. Fundamentals of Data Engineering.
No consumo, uma camada semântica pode centralizar medidas, relações, descrições e regras de acesso. Ela deve distinguir soma de receita, saldo de fechamento e clientes distintos, além de separar classificação histórica de classificação atual. Uma métrica bem definida em um dashboard não compensa uma FK errada na tabela que o alimenta.
Modelos largos para uma consulta específica, agregações e visões materializadas podem coexistir com fatos e dimensões. Sua função deve ser explícita, com rastreabilidade para a definição de negócio e reconciliação com os dados de origem. Performance deve ser avaliada sobre consultas reais, incluindo custo de leitura, shuffle, memória e manutenção.
20 Critérios para concluir o desenho
Um modelo dimensional está conceitualmente bem definido quando conseguimos explicar o que cada linha representa, por que suas medidas pertencem àquele grão, como cada entidade é identificada e qual regra temporal determina seus relacionamentos.
Na implementação, essa definição se traduz em chaves estáveis, dimensões com versões identificáveis, fatos com identidade de evento, resolução de FKs controlada e verificações que detectam perdas, duplicações e vínculos temporais incorretos.
As distinções centrais ficam claras: a dimensão precisa de unicidade na identidade de suas linhas, enquanto seus atributos podem se repetir; a fato concentra acontecimentos e medidas, mas pode conter identificadores textuais justificados; a BK identifica a entidade conforme um contrato, enquanto a SK identifica a linha dimensional; o hash de mudança detecta estados diferentes, mas não identifica necessariamente uma versão histórica.
No exemplo de C42, essas decisões permitem afirmar que R$ 800 pertencem ao segmento Varejo e R$ 200 ao Premium na perspectiva histórica. Se quisermos atribuir os R$ 1.000 ao segmento atual, o modelo pode oferecer essa leitura de forma explícita, sem alterar silenciosamente a pergunta.
Esse é o critério decisivo: a estrutura precisa sustentar uma interpretação verificável dos resultados, inclusive quando chegam correções, mudam classificações ou se repetem cargas. A tecnologia executa a consulta; o modelo estabelece o que sua resposta significa.
Referências para aprofundamento
A base bibliográfica central é The Data Warehouse Toolkit — The Definitive Guide to Dimensional Modeling, de Ralph Kimball e Margy Ross, 3ª edição, Wiley, 2013. As páginas técnicas do Kimball Group citadas ao longo do artigo apresentam publicamente as técnicas da obra. Catálogo de técnicas dimensionais do Kimball Group.
Fundamentos de Engenharia de Dados, de Joe Reis e Matt Housley, oferece a perspectiva do ciclo de vida e das responsabilidades que cercam a construção de produtos de dados. Edição original na O’Reilly.
Decifrando Arquiteturas de Dados, de James Serra, complementa o estudo ao discutir escolhas de arquitetura e suas relações com necessidades analíticas. Deciphering Data Architectures na O’Reilly.
Os links de Microsoft Learn, Databricks e dbt próximos aos respectivos trechos sustentam os aspectos de implementação. Comportamentos específicos de produto devem ser conferidos na versão usada. As tabelas, os valores e os exemplos de SQL deste artigo foram elaborados para demonstrar as decisões de modelagem; não representam uma implementação produtiva completa.

Comentários