MIGRAÇÃO DE DADOS
Da cópia técnica à preservação do significado
Um guia prático para levantamento, governança, mapeamento, grão, chaves, arquitetura em camadas, validação, cutover e operação.

Figura 1 — Visão geral do ciclo de migração adotado neste artigo.
Artigo técnico para profissionais de Engenharia de Dados
2026
Resumo
Migrações de dados falham com frequência não porque a equipe desconhece como copiar arquivos, executar cargas incrementais ou criar tabelas no ambiente de destino, mas porque o projeto começa sem um entendimento compartilhado sobre o que os dados representam. A ausência de requisitos claros, responsáveis pela decisão, definição de grão, chaves de negócio, regras de transformação e critérios de validação transforma um problema semântico em uma sequência de correções técnicas.
Este artigo propõe um processo de migração orientado por evidências e por contratos de dados. O foco é mostrar o que precisa ser decidido em cada etapa, quem deve decidir, como documentar exceções e como validar a passagem da origem para Landing, Bronze, Silver e Gold sem cair na armadilha de exigir igualdade literal entre estruturas que possuem propósitos diferentes. A premissa é simples: toda diferença precisa ser explicável; nem toda diferença é erro; e nem toda igualdade significa qualidade.
Princípio central — Migrar dados não é transportar valores de A para B. É preservar significado, rastreabilidade, confiabilidade e capacidade de decisão. |
Roteiro do artigo
1. Antes da primeira carga: defina o tipo de migração e o resultado esperado
2. Descoberta e levantamento: conheça o ecossistema antes de desenhar o alvo
3. Governança: identifique quem decide sobre cada dado
4. Mapeamento origem → alvo: transforme conhecimento tácito em contrato
5. Grão, chaves e identidade: o núcleo lógico da migração
6. Ingestão, Landing e Bronze: fidelidade, reprocessamento e auditoria
7. Silver: qualidade, padronização e semântica controlada
8. Gold: modele para o negócio, não para imitar o legado
9. Validação por etapa: o que comparar e com o quê
10. Cutover, execução paralela e reconciliação final
11. Operação pós-migração: observabilidade, reprocessamento e ownership
12. Antipadrões, checklist e definição de pronto
1. Antes da primeira carga: defina o tipo de migração e o resultado esperado
A expressão “migração de dados” costuma agrupar iniciativas muito diferentes. Um rehost pode buscar máxima compatibilidade com o ambiente atual; uma modernização para lakehouse pode alterar formatos, modelos, padrões de ingestão, tratamento de histórico e formas de consumo; uma migração cloud-to-cloud pode preservar parte da arquitetura e mudar governança, serviços gerenciados ou mecanismos de processamento. Se o projeto não declarar qual desses objetivos está perseguindo, a equipe discutirá “paridade” sem saber o que paridade significa.
O primeiro artefato da migração deve ser um documento curto de intenção: escopo, dados incluídos, consumidores, nível de transformação permitido, requisitos de histórico, janela de corte, tolerância a indisponibilidade, requisitos regulatórios e critérios de aceite. Isso evita que decisões fundamentais surjam tardiamente dentro de uma tarefa técnica.
Pergunta | Exemplo de decisão |
Estamos apenas movendo ou também modernizando? | Modernizar ingestão e modelo analítico; não reproduzir defeitos conhecidos do legado. |
O histórico completo é obrigatório? | Sim, desde 2021, com reconciliação mensal e trilha por lote. |
Quem é o consumidor final? | BI financeiro, produtos de dados e integrações operacionais. |
Qual é o nível de compatibilidade esperado? | Semântica equivalente; estrutura física pode mudar. |
Qual é a estratégia de corte? | Carga histórica, incremental, execução paralela e delta final. |

Figura 2 — A migração deve tratar explicitamente a diferença entre preservar significado e replicar defeitos.
Decisão importante — Quando o comportamento incorreto do legado precisa ser temporariamente preservado por compatibilidade, trate-o como uma regra versionada e com prazo de retirada. Não o deixe escondido no código. |
2. Descoberta e levantamento: conheça o ecossistema antes de desenhar o alvo
A fase de descoberta reduz o desconhecido. Ela existe para responder não apenas “quais tabelas existem?”, mas também “quem usa?”, “de onde realmente vem?”, “qual é a frequência?”, “há campos calculados?”, “há correções manuais?”, “qual sistema é autoritativo?”, “qual regra só existe na cabeça de alguém?” e “o que quebra se este dado mudar?”. Uma tabela tecnicamente simples pode ter alto risco se alimentar fechamento contábil, cobrança ou indicadores regulatórios.
O levantamento precisa combinar inventário técnico com investigação funcional. Catálogo, DDL, linhagem, logs de execução e amostragem de dados mostram uma parte. Entrevistas com especialistas do domínio, usuários e mantenedores revelam regras implícitas. Essa combinação é o que permite transformar um legado desconhecido em um domínio migrável.
Dimensão do levantamento | O que registrar |
Fonte e acesso | SGBD/arquivo/API, host lógico, schema, tabela, formato, codificação, credenciais por segredo, limites e SLAs. |
Volume e perfil | Quantidade de linhas, crescimento, partições, cardinalidade, nulos, duplicidades, valores fora do domínio. |
Temporalidade | Campo de criação/alteração, timezone, histórico disponível, late arrival, dados retroativos, fechamento. |
Dependências | ETLs, relatórios, APIs, planilhas, jobs, consumidores, tabelas auxiliares, lookups. |
Semântica | Significado de campos, fórmulas, códigos, exceções, regras manuais e sistema de registro. |
Riscos | Dados pessoais, regras regulatórias, indisponibilidade, limitações de origem, janela de extração. |
Entregável mínimo — Inventário de dados + mapa de dependências + perfil inicial + lista de riscos e dúvidas abertas. Sem isso, o desenho do alvo é uma hipótese. |
3. Governança: identifique quem decide sobre cada dado
Uma migração frequentemente trava no ponto em que a engenharia encontra uma inconsistência e ninguém sabe quem pode decidir. O banco contém “A”, “B” e “X”, a documentação só reconhece “A” e “B”, e a equipe técnica é pressionada a escolher um tratamento para “X”. Esse é um problema de governança, não de SQL.

Figura 3 — Papéis que precisam participar das decisões de uma migração.
A responsabilidade deve ser explícita por domínio ou conjunto de dados. O negócio define o significado e o aceite; o Data Owner responde pelo domínio; o Data Steward ou especialista detalha regras e exceções; a engenharia implementa, instrumenta e prova o comportamento; os consumidores validam se o resultado atende ao uso real. Em estruturas menores, uma pessoa pode acumular papéis, mas a decisão ainda precisa ser registrada.
Decisão | Quem deve aprovar | Evidência |
Significado de um campo | Data Owner / negócio | Definição no catálogo ou contrato |
Tratamento de código inválido | Data Steward / SME | Regra de qualidade + destino da exceção |
Deduplicação | Data Owner + engenharia | Chave, prioridade, tie-breaker e teste |
Cálculo de KPI | Negócio / consumidor | Fórmula, grão, janela e exemplos |
Mudança de chave de negócio | Data Owner + arquitetura | Impacto de relacionamento e histórico |
Aceite da migração | Owner + consumidores críticos | Checklist, reconciliação e UAT |
4. Mapeamento origem → alvo: transforme conhecimento tácito em contrato
O mapeamento não é uma planilha de “coluna A vira coluna B”. Ele é o contrato que explica como o significado é preservado ou alterado. Para cada atributo relevante, registre a origem, tipo, domínio, regra de transformação, nulabilidade, padrão de normalização, tratamento de exceção, criticidade, responsável pela decisão e forma de validação.
Origem | Alvo | Regra | Exceção | Validação |
status_cliente CHAR(1) | status_cliente STRING | A→ATIVO; B→BLOQUEADO | Outros códigos → quarentena | Distribuição por status + amostra rastreável |
cpf VARCHAR | cpf_normalizado STRING | Remover máscara; validar dígitos | Inválido não compõe BK | % válidos, nulos e duplicados |
dt_alt DATETIME | updated_at TIMESTAMP | Converter para UTC | Timezone desconhecido → flag | Min/max e contagem por dia |
vl_saldo NUMERIC | saldo_fechamento DECIMAL | Usar último evento válido do dia | Sem evento → regra acordada | Reconciliação por conta/data |
O mapeamento também precisa registrar o que não será migrado e o motivo. Campos obsoletos, técnicos, duplicados ou sem consumidor devem ser eliminados de forma deliberada. “Não entrou porque ninguém usou” é muito diferente de “não entrou porque foi esquecido”.
Boa prática — Versione o mapeamento junto com o código. Uma alteração de regra de transformação é uma mudança de contrato e deve ser rastreável. |
5. Grão, chaves e identidade: o núcleo lógico da migração
Antes de escrever o modelo alvo, descreva em linguagem simples o que uma linha representa. Esse enunciado é o grão. Em uma fato de transações, pode ser “uma linha por evento financeiro confirmado”. Em uma dimensão de cliente, pode ser “uma linha por pessoa por versão válida”. Em um snapshot diário, “uma linha por conta por data de referência”. O grão determina quais colunas podem formar unicidade e quais agregações fazem sentido.

Figura 4 — Relação entre pergunta de negócio, grão e estratégia de chaves.
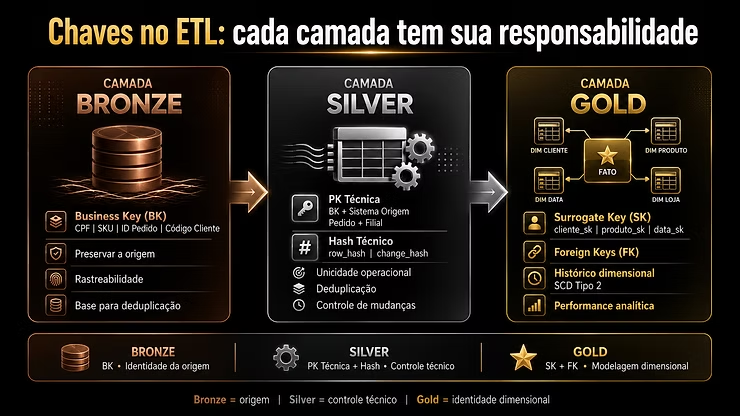
Em migrações, é comum confundir a chave técnica do legado com a identidade de negócio. Um ID sequencial pode ser apenas um detalhe de implementação e não sobreviver a múltiplas fontes. Por isso, separe os conceitos:
Chave natural: atributo ou combinação que identifica o registro no domínio, quando confiável.
Business Key (BK): representação controlada da identidade de negócio usada no modelo e nas regras de integração.
Surrogate Key (SK): chave técnica gerada no alvo, útil em dimensões e relacionamentos internos.
Hash de negócio ou hash de mudança: mecanismo técnico para comparação/detecção, não substituto automático da definição semântica da chave.
Uma BK ruim contamina deduplicação, SCD, joins e reconciliação. Portanto, antes de adotar “ID da origem”, teste estabilidade, reutilização, colidibilidade entre sistemas, presença histórica e comportamento em casos de fusão, cancelamento ou reativação.
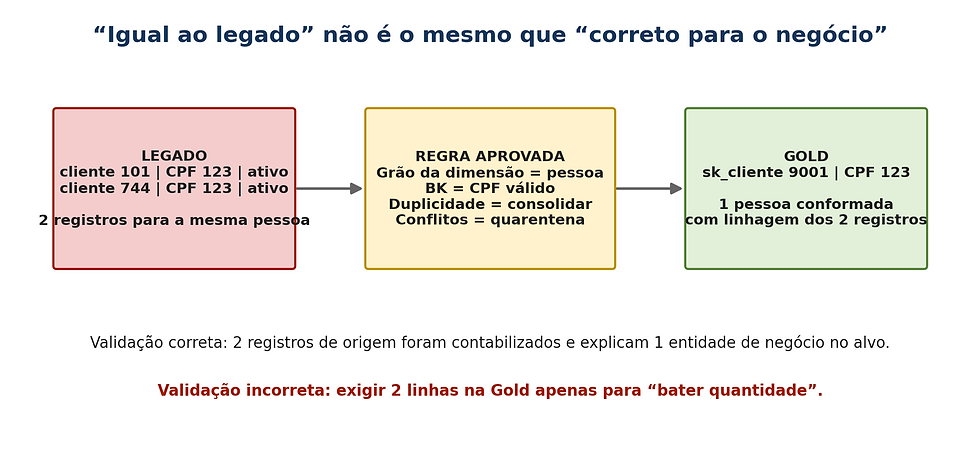
Figura 5 — Exemplo de por que a quantidade de linhas pode mudar legitimamente entre origem e Gold.
6. Ingestão, Landing e Bronze: fidelidade, reprocessamento e auditoria
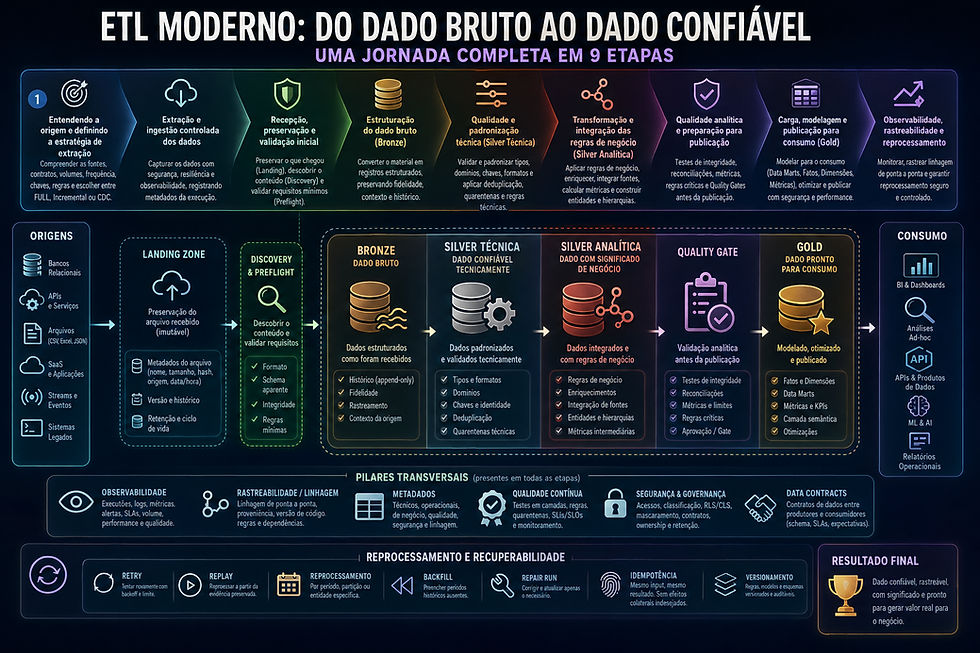
Neste artigo, Landing representa a zona de recepção do dado e Bronze representa a persistência bruta auditável. Essa convenção estende a arquitetura Medallion tradicional, em que Bronze já é a camada raw. O importante é que o projeto deixe claro onde termina a transferência e onde começa o histórico técnico persistido.
Na ingestão, a prioridade é não perder evidência. O dado deve chegar com metadados suficientes para reconstruir o que ocorreu: origem, arquivo ou partição, timestamp de ingestão, batch_id, intervalo de extração, watermark utilizado, hash do arquivo quando aplicável e status da carga. Transformações destrutivas devem ser evitadas nessa etapa.
Etapa | Objetivo | Validações recomendadas |
Origem → Landing | Garantir que a transferência terminou corretamente | Arquivos esperados, tamanho, checksum quando possível, contagem por extração, janela temporal, falhas de leitura. |
Landing → Bronze | Persistir o raw com metadados e parsing controlado | Linhas lidas x gravadas, schema capturado, registros malformados, colunas técnicas, duplicidade de lote. |
Reprocessamento | Reexecutar sem corromper histórico | Idempotência, batch_id, partição, overwrite/merge planejado, trilha de execução. |
Regra de ouro — Se a camada raw não permite reprocessar a Silver de forma determinística, a migração perde uma das suas principais garantias operacionais. |
7. Silver: qualidade, padronização e semântica controlada
Silver é o ponto em que o dado deixa de ser apenas recebido e passa a ser confiável para integração. É onde entram schema enforcement, tipagem, normalização, deduplicação, tratamento de nulos, domínio de valores, integração de fontes, resolução de late-arriving data e políticas de histórico. A documentação da Databricks descreve a camada Silver justamente como o estágio de limpeza, validação e enriquecimento; a qualidade deve aumentar à medida que o dado progride pelas camadas.
A regra crítica é separar correção legítima de alteração arbitrária. Se um CPF inválido impede a identificação confiável da entidade, a Silver não deveria “inventar” um CPF. Ela pode normalizar formatos válidos, marcar inconsistências, quarentenar, enriquecer a partir de uma fonte autorizada ou aplicar uma regra aprovada. A mesma lógica vale para códigos de status, datas impossíveis, duplicidades e relacionamentos incompletos.
Tipo de regra | Exemplo | Tratamento |
Sintática | CPF com máscara, texto com acento/caixa inconsistente | Normalizar de forma determinística. |
Domínio | status fora da lista aprovada | Quarentena ou valor “DESCONHECIDO” conforme contrato. |
Unicidade | duas linhas para a mesma BK no mesmo instante | Aplicar prioridade/tie-breaker documentado. |
Referencial | fato sem dimensão correspondente | Chave “desconhecido”, atraso controlado ou quarentena. |
Temporal | evento atrasado altera período já processado | Política de late arrival e janela de reprocessamento. |
Quarentena — Quarentena não é lixeira. Ela precisa de motivo, volume, criticidade, responsável, SLA de tratamento e possibilidade de reprocessamento. |
8. Gold: modele para o negócio, não para imitar o legado
A Gold costuma ser a camada mais distante estruturalmente da origem porque seu objetivo é servir ao consumo de negócio: modelos dimensionais, data marts, agregações, métricas e entidades conformadas. Isso não significa que ela pode divergir sem controle; significa que a forma de validação muda. A Gold deve ser rastreável até a origem e reconciliável com ela, mas a conformidade principal é com o grão, as regras de negócio e os contratos aprovados.
Exigir igualdade registro a registro entre uma tabela transacional do legado e uma fato agregada por dia é um erro de critério, não uma falha da migração. Da mesma forma, uma dimensão de cliente corretamente deduplicada pode ter menos linhas que o cadastro legado. A validação precisa responder por que houve diferença e se a diferença está prevista.

Figura 6 — Cada camada responde a uma pergunta de validação diferente.
Para fatos, valide explicitamente o grão e a aditividade das medidas. Uma medida de movimento pode ser somável; um saldo diário geralmente é semiaditivo no tempo e não deve ser somado indiscriminadamente entre datas. Para dimensões, valide BK, SK, atributos conformados, histórico SCD, registros desconhecidos e integridade referencial.
Pergunta-chave — Se a Gold “precisa bater com a origem”, defina exatamente o que deve bater: total financeiro por período? quantidade de eventos válidos? entidades únicas? saldo de fechamento? Nunca use “bater” como requisito sem uma métrica formal. |
9. Validação por etapa: o que comparar e com o quê
Validação de migração não é um único teste no final. É uma cadeia de evidências. Quanto mais cedo um erro é detectado, menor o custo de diagnóstico. O conjunto de testes deve avançar de integridade técnica para reconciliação volumétrica, qualidade, semântica e aceite de negócio.

Figura 7 — Camadas de evidência necessárias para afirmar que uma migração está reconciliada.
Comparação | O que deve ser validado | Quando diferenças são aceitáveis |
Origem x Landing | arquivos/lotes, tamanho, contagem, janela, ausência de perda | Somente se a extração foi definida como amostral ou filtrada. |
Landing x Bronze | linhas persistidas, parsing, schema, metadados | Registros inválidos podem ir para erro/quarentena, desde que contabilizados. |
Bronze x Silver | regras de qualidade, deduplicação, tipagem, domínios | Sim, quando regras aprovadas removem/mesclam/quarentenam registros. |
Silver x Gold | grão, joins, agregações, SK/BK, métricas | Sim, e frequentemente esperado por modelagem dimensional e agregação. |
Gold x negócio | KPI, comportamento, casos reais, UAT | Apenas dentro de tolerâncias ou exceções explicitamente aprovadas. |
Para cada divergência, registre classificação, causa, regra que a explica, volume afetado e aprovação. Essa prática muda a conversa de “não bateu” para “há 1.842 linhas consolidadas em 1.121 clientes porque a regra de identidade é CPF válido e existem duplicidades históricas documentadas”.
Exemplo de reconciliação | Resultado esperado |
COUNT(*) por batch_id | Provar completude de ingestão. |
COUNT DISTINCT(BK) por competência | Detectar perda, duplicidade ou mudança de identidade. |
SUM(valor) por período e domínio | Reconciliar medidas aditivas. |
MIN/MAX(data_evento) | Verificar cobertura temporal. |
Distribuição por status/categoria | Detectar alteração de domínio e mapeamento. |
Amostra rastreável por BK | Explicar transformação registro a registro. |
Registros em quarentena por regra | Medir dívida de qualidade e risco do corte. |
10. Cutover, execução paralela e reconciliação final
O cutover é uma mudança de sistema de confiança. Por isso, a virada deve ser preparada como um evento controlado, não como “o dia em que paramos o legado”. Uma estratégia típica inclui carga histórica, sincronização incremental, período de execução paralela, freeze quando necessário, delta final, alteração dos consumidores e hypercare.

Figura 8 — Sequência de cutover baseada em redução progressiva de incerteza.
Durante a execução paralela, compare resultados em janelas que representem o uso real. Um único dia “batendo” pode esconder efeitos de fechamento mensal, late-arriving data, feriados, virada de competência ou regras que só aparecem em casos raros. A janela deve ser proporcional ao ciclo do negócio.
Critério de go-live | Exemplo |
Carga histórica completa | 100% das partições previstas processadas; exceções contabilizadas. |
Incremental estável | Sem lacunas de watermark/CDC e com reexecução testada. |
Qualidade dentro do limite | Regras críticas sem violação; não críticas com aceite e plano. |
Reconciliação aprovada | Totais, entidades e KPIs dentro das tolerâncias acordadas. |
Consumidores validados | Dashboards, APIs e extrações críticas testados. |
Rollback definido | Critérios, responsáveis e procedimento exercitado ou revisado. |
11. Operação pós-migração: observabilidade, reprocessamento e ownership
Uma migração não termina no primeiro dia em produção. O alvo precisa entrar em operação com observabilidade suficiente para detectar falhas antes que os consumidores as encontrem. Isso inclui saúde da ingestão, atraso, volume, qualidade, schema drift, falhas de dependência, custo anômalo e comportamento de dados críticos.
Também é necessário preservar o ownership. Após o projeto, alguém continua responsável por aprovar mudanças de domínio, tratar violações de qualidade, atualizar contratos e decidir sobre novas fontes. Sem essa continuidade, o alvo moderno começa a acumular as mesmas ambiguidades do legado.
Sinal observável | Pergunta operacional |
Freshness | Os dados chegaram no horário esperado? |
Volume | O volume está dentro da faixa histórica ou houve queda/pico? |
Qualidade | Quais regras falharam e qual o impacto? |
Schema | Houve coluna nova, removida ou tipo alterado? |
Linhas rejeitadas | Quantas foram para quarentena e por quê? |
Reconciliação contínua | Totais e entidades continuam coerentes entre estágios? |
Custo/performance | Mudanças de volume ou desenho degradaram processamento? |
12. Antipadrões que aparecem repetidamente em migrações
Começar pelo código: A equipe cria pipelines antes de fechar escopo, grão, ownership e regras. Resultado: retrabalho estrutural.
Usar o legado como especificação perfeita: O legado contém decisões históricas, atalhos e defeitos. Ele é evidência importante, mas não substitui o significado do negócio.
Validar Gold com COUNT(*) do legado: Contagem de linhas ignora agregação, deduplicação, SCD e mudança de grão.
Deixar exceções escondidas: CASE WHEN e filtros ad hoc viram “regra” sem dono e sem rastreabilidade.
Chamar qualquer ID de chave de negócio: IDs técnicos podem ser instáveis entre sistemas e não representar identidade real.
Excluir registros sem contabilizar: Toda perda precisa aparecer como rejeição, quarentena, regra de exclusão ou decisão aprovada.
Cutover sem rollback: Se não existe forma de voltar ou corrigir, o risco operacional foi transferido para o consumidor.
13. Checklist prático de uma migração bem estruturada
☐ Escopo, objetivo e tipo de migração definidos.
☐ Inventário de fontes, consumidores e dependências concluído.
☐ Data Owner / responsável por domínio identificado.
☐ Mapeamento origem → alvo versionado e aprovado.
☐ Grão de cada dataset descrito em linguagem de negócio.
☐ BK, SK, regras de deduplicação e histórico definidos.
☐ Estratégia de ingestão, incrementalidade, watermark/CDC e reprocessamento documentada.
☐ Metadados de lote e linhagem disponíveis desde a ingestão.
☐ Regras de qualidade classificadas por criticidade.
☐ Quarentena com SLA, motivo e responsável.
☐ Critérios de validação específicos por etapa definidos antes da execução.
☐ Reconciliações por volume, chave, período, domínio e medida implementadas.
☐ Diferenças entre origem e alvo documentadas e explicadas.
☐ UAT com consumidores críticos concluído.
☐ Plano de cutover, execução paralela e rollback definido.
☐ Observabilidade e ownership pós-migração ativados.
14. Definição de pronto por etapa
Etapa | Pode avançar quando... |
Descoberta | fontes, dependências, riscos e dúvidas críticas estão registrados. |
Governança | há responsáveis e um processo de decisão para ambiguidades. |
Mapeamento | campos, regras, exceções e critérios de validação estão aprovados. |
Ingestão/Bronze | a transferência é completa, auditável e reprocessável. |
Silver | qualidade, identidade, deduplicação e regras temporais são determinísticas. |
Gold | grão, relacionamentos e métricas atendem aos contratos de negócio. |
Validação | diferenças são explicadas e aceitas; não existem divergências críticas sem dono. |
Cutover | consumidores, rollback, monitoração e suporte estão prontos. |
15. Conclusão
Os problemas mais caros de uma migração de dados geralmente nascem antes da primeira linha de código: requisitos incompletos, ausência de ownership, semântica não documentada, grão indefinido e critérios de validação genéricos. Quando essas lacunas existem, a engenharia acaba tentando resolver por implementação decisões que deveriam ter sido tomadas por governança e pelo domínio.
Um processo robusto muda a ordem do trabalho. Primeiro entende, depois define, então implementa, valida e só então promove o dado para consumo. Landing e Bronze preservam a evidência; Silver controla qualidade e identidade; Gold expressa o modelo de negócio. A validação acompanha essa evolução: começa pela fidelidade técnica e termina no aceite semântico e funcional.
A origem continua fundamental durante toda a migração, mas seu papel muda. Ela é a referência para demonstrar que nada foi perdido e para rastrear como o alvo foi construído. Ela não precisa ser o molde permanente do novo ambiente. Uma plataforma de dados bem projetada deve ser capaz de explicar cada diferença entre legado e alvo — inclusive quando o resultado correto é, deliberadamente, diferente.
Síntese — Uma migração está concluída quando o novo ambiente consegue provar de onde o dado veio, por que ele tem aquele valor, qual regra o transformou, quem aprovou a regra e como reprocessá-lo se necessário. |
Referências e leituras complementares
Databricks — Medallion Architecture. Referência para organização em camadas com qualidade crescente entre Bronze, Silver e Gold.
Databricks — Reliability best practices. Práticas de confiabilidade e qualidade em arquitetura lakehouse.
Microsoft — Cloud Adoption Framework: Assess workloads for cloud migration. Ênfase em descoberta de componentes, dependências e requisitos antes da migração.
Microsoft — Planeje sua migração. Planejamento, priorização e sequência de migração.
Microsoft — Migration wave planning. Organização de migração em ondas para reduzir risco e complexidade.
Nota: a arquitetura em camadas apresentada no artigo é uma adaptação prática para cenários de engenharia de dados que utilizam Landing + Bronze + Silver + Gold. A nomenclatura pode variar entre organizações; o essencial é explicitar a responsabilidade de cada estágio e seus critérios de qualidade.

Comentários